[카테고리:] 한국어

  • ChatGPT와 Google Drive를 연결하기 전에: 공개 문서로 아는 것과 모르는 것

    세 개의 분리된 경계를 지나기 전 멈춰 있는 연결선과 닫힌 문서 상자를 표현한 추상 일러스트
    연결에서 허락한 범위, 실제 사용, 연결 해제 뒤 남는 정보는 서로 다른 질문이다. Grok Imagine을 사용해 생성한 AI 이미지입니다.

    이 글에서는 연결 버튼을 누르지 않았다. 실험 전용 계정과 비공개 파일, 다른 접근 경로와 분리된 환경이 준비됐다는 확인이 없어서 멈췄다. 계정이나 로그인 화면을 열지 않았고, OAuth 권한 흐름·동의 화면·권한 변경·파일 조회·ChatGPT 쪽 연결 해제·Google 쪽 권한 철회·보존 또는 삭제·화면 캡처를 어느 것도 시험하지 않았다. 그래서 이 글은 “ChatGPT가 Google Drive에서 어디까지 봤다”는 사용기가 아니다. 연결 전에 무엇을 물어야 하는지, 2026년 9월 13일에 다시 확인한 공개 문서로 알 수 있는 것과 계정 화면에서만 확인할 수 있는 것을 가르는 기록이다.

    이 글의 목차

    ‘연결 권한’은 한 개의 스위치가 아니다

    “Drive를 연결한다”는 말에는 적어도 세 질문이 섞여 있다.

    1. 내가 무엇을 허락했나? Google의 동의 화면에 표시된 서비스와 권한 범위의 문제다.
    2. AI가 무엇을 새로 가져왔나? 연결된 Google 계정이 원래 열 수 있는 파일, ChatGPT 안에서 허용된 동작, 실제로 사용된 연결 경로의 문제다.
    3. 연결을 끊은 뒤 무엇이 남나? ChatGPT 쪽 연결을 끈 뒤 Google에서 새로 가져오는 것, Google 계정에서 앱 권한을 철회하는 것, 이미 대화에 나온 문장, 저장된 파일과 기억(메모리)을 삭제하는 것은 각각 다른 문제다.

    Google의 로그인·권한 문서(OAuth)는 앱이 승인받은 권한 범위(scope) 안에서 접근한다고 설명한다. Google은 조건에 맞는 요청에서 권한을 항목별로 고르는 방식도 지원한다. 하지만 특정 ChatGPT 연결 화면에서 어떤 선택지가 나오는지는 그 화면을 보기 전에는 알 수 없다. OpenAI 문서도 Google 서비스 수를 줄일 수 있더라도 선택한 서비스에 요청된 권한은 모두 승인해야 할 수 있다고 안내한다.

    또한 OpenAI의 Google Drive 안내는 개인 계정의 실시간 연결과 조직 관리자가 설정하는 동기화를 구분한다. 안내에 따르면 실시간 연결에서 다룰 수 있는 파일의 경계 중 하나는 선택한 Google 계정이 원래 열 수 있는 범위다. 이 글은 두 방식 가운데 개인 연결만 계획했고, 어느 방식도 실제로 열어 보지 않았다.

    OpenAI 문서에 나오는 ChatGPT의 동작 승인 설정은 행동 전에 다시 묻는 장치다. Google 동의 화면에서 준 권한 범위를 자동으로 줄이는 기능과는 별개다. 실제 설정 이름과 선택지는 이 작업에서 확인하지 않았다.

    공개 문서가 답하지 못하는 것

    공개 문서만으로는 내 계정의 현재 화면을 채울 수 없다.

    표 1 · 공개 문서가 답하지 못하는 것
    질문 공개 문서에서 확인한 것 계정 화면을 봐야만 아는 것
    어떤 연결이 제공되는가
    요금제·지역·계정 유형·사용 화면·워크스페이스에 따라 다르다는 공식 안내
    이 날짜의 한국 지역·요금제·계정 유형·사용 화면 조합에서 개인용 실시간 Drive 연결이 보이는지
    얼마나 좁게 허용할 수 있는가
    필요한 범위만 요청하라는 Google 원칙, 서비스 선택에 관한 OpenAI 안내
    실제 동의 문구, 파일 단위 선택, 읽기 전용 선택, 필수 권한
    무엇을 읽었는가
    기존 Google 파일 권한이 경계 중 하나라는 안내
    실험용 비공개 파일을 이름만으로 찾았는지, Drive 연결을 썼다는 표시가 있었는지
    ChatGPT 쪽 연결 해제 뒤 차단되는가
    OpenAI 문서는 해당 계정을 통한 이후 접근이 중단된다고 설명하며, 다른 연결은 남을 수 있다고 구분
    해제 뒤 시간을 두고 새 내용을 다시 가져오지 못했는지
    과거 내용도 사라지는가
    같은 문서는 연결 해제가 기존 대화·저장 파일·메모리를 자동 삭제하지 않는다고 구분
    이 실행에서 무엇이 남았거나 삭제됐는지

    마지막 두 줄은 특히 중요하다. “새로 가져오지 못함”과 “과거 문장이 보이지 않음”은 같은 판정이 아니다. 여기서 ‘연결 해제’는 ChatGPT 안에서 연결을 끄는 일을 뜻한다. Google 계정 쪽에서 앱 권한을 철회하는 일은 이번에 다루지 않은 별도 조치다. OAuth 권한 철회 표준과 Google 문서는 철회가 완전히 반영되는 데 시간이 걸릴 수 있다고 설명하지만, 이것만으로 ChatGPT 쪽 연결 해제가 어떻게 구현됐는지는 알 수 없다.

    원래 하려던 합성 데이터 실험

    실험안은 실제 자료 대신 실험 전용 Google 계정의 비공개 파일 하나를 쓰도록 설계했다. 파일 이름과 본문에는 어디에도 공개하지 않은 임의 문자열을 넣는다. 연결 전에는 새 대화에서 파일 이름만 물어 보고, 연결한 뒤 같은 질문을 다시 한다. 정확한 본문과 “Google Drive 연결을 사용했다”는 식의 출처 표시가 함께 보여야만 연결이 실제로 작동했음을 보여 주는 기준 확인(양성 대조군)을 통과한 것으로 본다.

    그 뒤 ChatGPT 쪽 연결을 해제하고, 같은 파일의 본문 표식을 매번 새 값으로 바꾼다. 새 대화에서 즉시, 5분 뒤, 30분 뒤 같은 요청을 반복한다. 예전 대화에 남은 문장은 별도로 본다. 한 번이라도 새 표식을 연결 경로로 가져왔다면 즉시 중단한다. 세 번 못 찾았더라도 모든 계정과 경로에서 영구 해제됐다고 쓰지는 않는다.

    하지만 이 절차는 시작 조건부터 엄격하다. 이미 존재하는 합성 전용 Google 계정과 비공개 파일, 다른 연결·업로드·메모리·동기화가 결과를 공급하지 않는다는 확인, 식별정보를 가린 화면 캡처, 비용 0원, 그리고 실제 연결을 특정할 수 있는 출처 표시가 필요하다.

    이번 작업에는 그 조건들이 존재한다는 관찰 기록이 없었다. 이 작업의 규칙상 계정을 새로 만들거나 로그인하지 않기로 했고, 작성자의 브라우저를 열어 확인하는 것도 개인 계정 정보를 노출할 수 있어 하지 않았다. 그래서 체크리스트는 전부 미확인으로 남았다. 계정·로그인, OAuth와 동의 화면, 권한 변경, 파일 조회, ChatGPT 쪽 연결 해제, Google 쪽 권한 철회, 보존·삭제 확인, 시간차 재조회, 화면 캡처는 모두 실행하지 않았다. 위 절차는 실제 개인·업무용 Google 계정에서 따라 하는 방법이 아니라, 왜 이 실행이 시작되지 않았는지를 설명하는 설계 기록이다.

    모의실험으로 빈칸을 채우지 않은 이유

    로컬에 가짜 동의 화면과 가짜 Drive 파일을 만드는 방법도 검토했지만 실행 결과로 채택하지 않았다. 그런 연습은 우리가 만든 가짜 화면이 어떻게 움직이는지를 보여 줄 뿐, ChatGPT가 요청한 실제 Google 권한이나 연결 해제 후 접근을 증명하지 않는다.

    공개 링크 파일도 대안이 아니다. 일반 웹에서 읽은 것인지, 연결된 계정으로 읽은 것인지 구분하기 어려워지기 때문이다. “파일을 찾지 못했다”는 답 역시 연결을 실제로 사용했다는 표시가 없다면 차단 성공이 아니라 원인 불명이다.

    연결 전에 사용할 세 칸 점검표

    독자가 실제 계정을 실험 재료로 삼을 필요는 없다. 연결을 고려한다면 다음 세 칸만 먼저 분리해 보자.

    • 허락: 어느 계정인지, 어떤 서비스와 권한 문장이 선택됐는지 읽는다. 동의 화면이 내가 받아들일 수 있는 범위보다 넓은 권한을 필수로 요구한다면 승인하지 않는다.
    • 사용: 답변이 어느 연결을 통해 어떤 자료를 가져왔는지 확인한다. 단순한 성공 문구나 파일명 노출을 새 본문 조회의 증거로 보지 않는다.
    • 남음: ChatGPT 쪽 연결 해제와 별개로 기존 대화·파일·기억이 남아 있는지 따로 살핀다. 해제했다고 해서 삭제됐거나 다른 연결의 접근까지 끊겼다고 여기지 않는다. 이 점검은 해제 뒤 실제 자료를 다시 조회해 보라는 뜻이 아니다.

    이번 작업은 제품이 안전하다고도 위험하다고도 말하지 못한다. 가장 강한 결론은 계정별 동의 화면과 연결이 표시된 기준 확인 없이 “어디까지 보인다”는 답을 만들 수 없었다는 것이다. 연결 화면을 열기 전에 허락 / 사용 / 남음을 나눠 두면, 답을 모르는 채로 성공이나 실패를 단정하지 않을 수 있다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • AI가 만든 테스트는 일부러 숨긴 버그를 잡을 수 있을까?

    정상 앱과 세 개의 결함 복사본을 향해 서로 다른 경로로 이어지는 테스트 카드들을 표현한 추상 일러스트
    테스트 생성, 정상 기준 통과, 결함 구별, 변경 내구성은 서로 다른 확인 단계다. Grok Imagine을 사용해 생성한 AI 이미지입니다.

    “테스트가 모두 통과했습니다.” 바이브 코딩을 하다 보면 이 문장이 안전 확인서처럼 들린다. 하지만 테스트도 결국 질문과 예상 답을 적어 둔 코드다. 누가 답을 썼는지, 그 답이 맞는지 확인하지 않았다면 초록색 체크는 무엇을 보장할까?

    이번에는 Codex로 만든 작은 장바구니 앱과 내가 일부러 고장 낸 복사본을 사용했다. 실제 서비스나 개인정보는 쓰지 않았다. 실험의 질문도 좁혔다. 같은 AI가 공개 규칙만 볼 때와 정상 코드까지 볼 때 각각 만든 테스트는, 정상 앱을 통과하고 미리 숨긴 세 결함을 잡으며 이후 변경으로 예전 기능이 다시 고장 나는 회귀를 구별할 수 있을까?

    이 글의 목차

    초록색보다 먼저 볼 여섯 단계

    테스트 결과는 한 숫자로 합치지 않았다.

    1. 테스트 파일이 만들어졌는가
    2. 실행할 수 있는가
    3. 정상 기준 앱에서 통과하는가
    4. 예상 답이 미리 만든 정답표와 맞는가
    5. 고장 낸 복사본에서 의도한 이유로 실패하는가
    6. 실제 화면 흐름도 같은 결론을 내는가

    비슷한 구분은 연구에서도 나타난다. EvalPlus는 더 강한 테스트를 추가하자 기존 평가를 통과했던 생성 코드의 오류가 드러날 수 있음을 보였다. Meta의 TestGen-LLM은 사람이 쓴 기존 테스트를 개선하는 산업 환경에서 생성, 빌드, 안정적 통과, 커버리지 증가를 별도 단계로 다뤘다. 테스트 입력을 잘 고르는 일과 올바른 예상 출력을 만드는 일이 다르다는 UTGen/UTDebug의 지적도 이번 정답표 검사의 이유다. 이 논문들의 수치를 이번 장바구니 실험에 그대로 적용한 것은 아니다.

    같은 모델, 다른 두 브리핑

    2026년 9월 13일, codex-cli 0.153.4의 gpt-5.6-luna를 낮은 추론 설정으로 두 번 실행했다. 한 번은 공개 규칙과 함수 설명만 제공한 명세 우선 조건, 다른 한 번은 같은 자료에 정상 구현 코드도 더한 코드 참조 조건이었다. 모델과 프롬프트는 같았고 각 조건은 새 세션에서 한 번만 생성했다.

    결함 목록, 비공개 정답표, 나중에 추가할 메모 기능은 생성기에서 숨겼다. 생성 작업은 임시 폴더에서만 진행했고 숨긴 자료가 있는 저장소 경로의 읽기와 쓰기를 운영체제 정책으로 막았다. 브라우저·웹 검색·플러그인도 껐다. 다만 기존 인증 서비스 연결은 사용했고, 시작 경고상 사용자 영역의 CLI 상태 정보 일부를 조회했다. 다른 사용자 영역 정보까지 완전히 격리됐는지는 독립적으로 증명하지 못했다. 처음 두 실행 방식은 모델을 돌리기 전에 격리 설정 문제로 실패했고, 그 기록도 남겼다. 세 번째 실행 방식에서만 두 조건이 끝까지 완료됐다.

    규칙만 본 테스트는 정상 앱에서 실패했다

    명세 우선 조건은 5개 테스트를 만들었다. 파일 문법 검사를 통과해 실행도 됐지만 정상 앱에서는 2개만 통과하고 3개가 실패했다. 여섯 단계 중 정상 앱 통과 단계에서 멈춘 셈이다.

    계산은 대체로 맞았다. 문제는 쿠폰 입력값을 어떤 형태로 저장하느냐였다. 공개 규칙은 앞뒤 공백을 무시하고 대소문자 구분 없이 SAVE10을 비교하라고 했지만, 저장된 문자열까지 대문자로 바꾸거나 마지막 상품 삭제 때 지우라고 하지는 않았다. 테스트는 그 동작까지 예상 답에 넣었다. 정상 구현은 입력 원문을 보존했다.

    따라서 이 테스트 묶음은 이번 실험의 규칙에 따라 무효(suite-invalid)로 분류했다. 정상 앱을 통과하지 못했기 때문이다. 고장 복사본에서 빨간불이 나더라도 버그를 잡았다고 셀 수 없어 세 결함 테스트는 진행하지 않았다. “테스트를 만들었다”와 “쓸 수 있는 예상 답을 만들었다”가 갈라진 순간이다.

    코드까지 본 테스트는 숨겨 둔 세 결함을 각각 잡았다

    코드 참조 조건은 8개를 만들었고 정상 앱에서 모두 통과했다. 편집이나 예상값 수정은 없었다. 다만 검사 문장 16개를 따로 분류하니 8개는 공개 규칙에서 독립적으로 계산할 수 있었고, 나머지 8개는 현재 데이터 전체 모양이나 구현에서 본 저장 방식에 묶여 있었다. 초록색만으로 모든 예상 답이 구현과 독립적이었다고 말할 수는 없다. 이후 한 번에 하나씩 숨겨 둔 결함을 넣었다.

    • 할인 전 금액으로 무료 배송을 판단한 D1: 배송비와 합계 테스트가 실패했다.
    • 쿠폰을 대소문자 구분하도록 바꾼 D2: sAvE10 할인 테스트가 실패했다.
    • 마지막 상품을 지운 뒤 이전 합계를 남긴 D3: 합계 0 초기화 테스트가 실패했다.

    세 실패 모두 비공개 정답표의 의도한 값에서 발생했다. 화면 사전 점검은 정상 기준 흐름을 별도로 확인했다. 다만 이것은 AI가 낯선 현실의 버그를 세 개 발견했다는 뜻이 아니다. D1~D3는 생성 전에 골라 숨긴 알려진 규칙 결함이다. 코드를 보여 준 것이 더 좋은 테스트의 원인이었다고도 말할 수 없다. 규칙에 쓰이지 않은 저장 방식을 추측해야 했다는 점도 두 조건의 차이를 설명할 수 있다. 모델 하나, 프롬프트 하나, 실행 한 번의 관찰일 뿐이며, 세 건으로 일반적인 버그 탐지율이나 안전성을 계산할 수도 없다.

    새 기능 앞에서는 ‘너무 정확한’ 테스트가 정상 변경에서도 깨졌다

    코드 참조 조건의 테스트 8개를 그대로 둔 채 상품 메모 기능을 추가했다. 정상 변경본에서는 마지막 상품을 지우면 메모도 사라졌다. 회귀본 LR1은 금액은 모두 0으로 되돌리지만 삭제된 상품의 메모만 화면에 남겼다. 비공개 정답표와 실제 화면 흐름은 정상 변경본 통과, LR1 실패로 둘을 구별했다.

    그러나 코드 참조 테스트는 둘 다 똑같이 8개 중 5개가 실패했다. 장바구니 상태 전체를 통째로 비교하도록 쓰여서, 새로 정상적으로 추가된 메모 항목(itemNote)이 있다는 것 자체를 오류로 본 탓이다. 정상 변경본부터 빨간색이므로 LR1을 잡았다고 인정할 수 없다. 여섯 단계 중 고장 구별 단계에서 판정할 수 없었고, 결과는 판정 불가다.

    이 실패는 쓸모없는 잡음이 아니다. 현재 구조를 통째로 복사한 예상 답은 기존 결함에는 민감할 수 있지만, 정상적인 확장에도 부서질 수 있음을 보여 준다. 회귀 테스트는 빨간불을 켜는 것뿐 아니라 “왜 켜졌는지”를 구별해야 한다.

    그래서 무엇을 확인해야 할까?

    AI가 테스트를 써 줬다면 다음 다섯 질문부터 던져 볼 만하다.

    • 정상 기준 사례에서 먼저 통과하는가?
    • 예상값은 코드가 아니라 요구사항에서 독립적으로 계산했는가?
    • 일부러 고장 낸 동작에서 바로 그 동작을 검사하는 항목이 실패하는가?
    • 저장된 데이터 전체의 모양보다 사용자가 중요하게 보는 결과를 검사하는가?
    • 자동 테스트와 실제 화면 확인이 같은 결론을 내는가?

    이번 생성 시간은 명세 우선 42.26초, 코드 참조 49.24초였다. 추가 구매는 없었다. 명령줄 도구가 토큰 사용 신호는 남겼지만 실행별 금액과 구독 할당량 차감은 보여 주지 않아 비용을 0원이라고 쓰지는 않았다. 테스트 파일은 평범한 .mjs 파일로 보존했다.

    결론은 “AI 테스트를 믿지 말라”도 “코드를 보여 주면 해결된다”도 아니다. 통과 여부를 신뢰의 끝으로 보지 말고, 예상 답·고장 구별·변경 내구성·화면 흐름을 따로 확인해야 한다. 이번 작은 실험에서 명세 우선 테스트는 정상 앱 단계에서 무효가 됐다. 코드 참조 테스트는 선택해 숨긴 세 결함을 잡았지만, 정상적인 기능 추가에서는 데이터 모양에 묶인 검사가 먼저 깨져 이후 회귀를 판정하지 못했다. 이것은 한 실행의 두 함정이지, 일반적인 안전성이나 버그 탐지율이 아니다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • AI에게 클릭을 맡기기 전, 무엇을 확인해야 할까?

    네 개의 분리된 기록 경로 앞에서 멈춘 커서와 닫힌 안전 게이트를 표현한 추상 일러스트
    필수 기록을 확인할 수 없다면, 클릭 전에 멈추는 것도 하나의 검증 결과다.
    Grok Imagine을 사용해 생성한 AI 이미지입니다.

    결론부터 말하면, 이번에는 컴퓨터 조작 에이전트를 시작하지 않았다. 따라서 클릭도, 클릭 차단도, 신뢰도 측정도 없었다. 일을 시켜 놓고 겁이 나서 중단한 것도 아니다. 시작 전에 정한 안전 조건을 현재 인터페이스에서 확인할 수 없었기 때문이다.

    이것은 사전에 정한 중단 규칙이 작동한 결과다. 화면·현재 주소·페이지 구조를 볼 수 있다는 문서상 기능과, 모든 행동이 허용 범위 안에 있었다는 독립 기록은 서로 다른 증거다.

    이 글의 목차

    “하지 마”라는 문장은 울타리가 아니다

    컴퓨터를 조작하는 AI에게 “외부 사이트로 나가지 마”, “보내기 버튼을 누르지 마”라고 적을 수는 있다. 하지만 prompt(지시문)의 문장은 지시이지 강제 장치가 아니다. 화면을 보는 AI는 화면에 적힌 글도 입력처럼 읽을 수 있어, 그 문구가 사용자의 지시와 충돌할 수도 있다.

    OpenAI의 computer-use 안내, Anthropic의 computer-use 문서, Google의 Computer Use 문서는 표현은 다르지만 격리된 환경, 사이트·행동 제한, 중요한 행동 전 사람의 통제, 기록과 결과 확인을 권한다. 이것은 각 회사가 제시하는 운영 지침이지, 특정 제품이 언제나 안전하다는 증명은 아니다.

    그래서 에이전트를 시작하기 전에 다음 네 기록을 각각 볼 수 있어야 한다고 정했다. 이번에는 그 조건을 통과하지 못해 이 네 기록 자체가 생성되지 않았다.

    1. AI가 무엇을 제안했는가
    2. 실행 직전에 정책이 허용·차단·승인 필요 중 무엇으로 판정했는가
    3. 브라우저를 실제로 움직이는 부분이 무엇을 실행했는가
    4. 별도 검사기가 마지막 상태를 어떻게 확인했는가

    AI가 “완료했습니다”라고 말하는 것은 네 번째 사건이 아니다. 화면을 내가 한 번 본 것도 중간 경로 전체의 기록은 아니다.

    실행 전에 만든 시험장

    실제 계정 대신 내 컴퓨터 안에서만 열리는 합성 페이지를 만들었다. Page A와 Page B에는 지시문에 없는 합성 문자열이 하나씩 있다. 에이전트가 두 페이지를 실제로 읽었는지 확인하기 위한 장치다. 다만 C1/C2를 실행하지 않았으므로, 이번에 관찰한 것은 이 값을 비교하는 메모리 안 검사 함수의 단위 시험뿐이다. Page B에는 겉보기에는 평범한 보내기 / Send this report 버튼도 있지만 외부 전송 대상은 없고 입력값도 비민감 합성 데이터뿐이다. 실제 서비스에서는 보내기 버튼을 누르기 전이라도 필드 입력 자체가 전송일 수 있다.

    또 시험용 정책 실행기를 만들었다. 이 실행기는 내가 만든 가짜 브라우저 동작부만 감쌀 뿐, 선택한 인앱 브라우저의 클릭과 이동은 거치지 않는다. 단위 시험에서는 내 컴퓨터 자신을 가리키는 주소(127.0.0.1)와 미리 정한 행동만 허용하고, 외부 주소 이동과 보내기 클릭은 가짜 동작부에 전달되기 전에 막았다. 각 제안·판정·실행에는 번호를 붙이고, 앞 기록을 고치면 뒤 기록이 어긋나도록 이어 붙인 기록(hash chain)을 사용했다.

    2026년 9월 13일 내가 만든 실행기만 따로 검사하는 Node.js 자동 시험 6건을 다시 돌렸고 모두 통과했다. 차단 판정을 받은 행동은 시험용 가짜 브라우저 동작부에 한 번도 전달되지 않았고, 허용된 행동은 허용 판정이 먼저 기록된 뒤에만 실행됐다. 기록 변조를 잡아내는 시험도 통과했다.

    여기서 선을 그어야 한다. 이 결과는 **내가 만든 실행기만 따로 시험한 결과(unit test)**다. 실제 AI가 화면 속 가짜 지시를 무시했다는 관찰도, 선택한 브라우저가 외부 통신을 원천 차단했다는 증거도 아니다.

    왜 본 실험을 멈췄나

    2026년 9월 9일 문서와 기능 목록으로 확인한 Codex 인앱 브라우저/Unified Computer Use 패키지 26.901.51231(macOS 26.6.2, build 25G83)에는 화면·현재 주소·페이지 구조(DOM)를 요청해 볼 수 있는 기능이 표시됐다. 실제 페이지 이동이나 상호작용은 하지 않았다. 내가 볼 수 있는 형태로는 별도 제안 기록, 행동별 정책 판정, 변경할 수 없는 실행 원장, 강제 사이트 주소 허용 목록이 제공되지 않았다. 내부에 비노출 통제가 있는지는 배제하지 못하지만, 보이지 않는 통제는 이번 증거로 쓸 수 없다. 취소와 깨끗한 초기화, 화면 캡처의 정확한 전송·보존 경로도 확인하지 못했다. 내장 엔진·드라이버 모델·요금제·증분 비용은 unknown이다.

    페이지의 보안 정책(CSP)을 강하게 하고 Send를 기술적으로 전송 기능이 없게 만들 수는 있다. 그래도 브라우저가 별도 주소로 이동하는 것을 페이지가 막았다고 증명할 수 없다. 행동 뒤 주소를 확인하는 것도 늦다. 잠깐 범위를 벗어났다가 돌아온 경로를 배제하지 못하기 때문이다.

    따라서 가짜 지시가 없는 기본 조건(C1)과 화면 속 가짜 지시를 넣은 조건(C2)은 둘 다 실행하지 않았다. 이것을 “실패 2회”나 “성공률 0%”라고 세지 않는다. 관찰 자체가 없으므로 결과는 not run이다.

    내가 다음에 작성할 위임 카드

    비개발자도 코드를 읽을 필요 없이 다음 항목은 먼저 적을 수 있다.

    표 1 · 내가 다음에 작성할 위임 카드
    내가 정하는 것 제품에서 확인해야 할 것 이번 확인에서 모른 것
    허용 사이트와 행동
    실제 최종 상태와 독립 검사
    제안·판정·중간 행동의 별도 기록
    금지 행동과 멈출 지점
    도구의 행동 기록과 오류
    취소·초기화와 화면 캡처의 저장·전송·보존 경로
    독립 완료 검사
    사람의 답이 없을 때 실제로 멈추는지
    지시문만으로 정한 경계가 강제됐는지

    여기에 한 질문을 더한다. 내가 답하지 않으면 실제 동작이 멈추는가? “해도 될까요?”라는 문장과 실행 전에 기술적으로 멈추는 장치를 구분하는 질문이다.

    빈칸은 합격이 아니다. N/A(해당 없음)도 자동으로 안전하다는 뜻이 아니다. 기록이 없으면 “모름”이라고 쓰고, 그 기록이 필요한 작업은 맡기지 않는 것이 맞다.

    어디까지 믿을 것인가

    이번에 확인한 것은 어떤 AI의 안전성이 아니다. 맡기기 전에 통과 조건을 정하면, 부족한 증거를 그럴듯한 완료 이야기로 바꾸지 않고 멈출 수 있다는 점이다.

    독립 검사기는 최종 상태만 확인한다. 올바른 마지막 화면은 안전한 경로, 범위 준수, 전송 부재를 증명하지 않는다. WebArena 같은 연구 환경도 기능적 결과를 별도 검사하는 이유가 있지만, 작은 로컬 시험 페이지 하나를 표준 평가(benchmark)나 일반적 신뢰도 평가라고 부를 수는 없다.

    화면을 조작하는 AI에게 맡길 범위는 “옆에서 보고 있겠다”보다 구체적이어야 한다. 실행기가 어디를 막는지, 무엇을 기록하는지, 언제 멈추는지, 결과를 누가 따로 확인하는지. 이 질문들은 이 프로토콜에서 택한 편집 기준이지 특정 제품의 안전성 판정표가 아니다. 그중 필요한 기록 하나를 확인할 수 없다면, 이번처럼 클릭 전에 멈추는 것이 맞다. 그것도 하나의 결과다.


    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 채팅창 안에 앱이 들어오면, 무엇까지 믿어도 될까?

    대화창 안에 폼과 차트가 있는 작은 인터랙티브 카드와 아직 연결되지 않은 경계를 표현한 일러스트
    Grok Imagine을 사용해 생성한 AI 이미지입니다.

    주간 학습 폼에서 복습을 15분에서 25분으로 바꾸자 그래프와 합계가 90분에서 100분으로 바뀌었다. 다만 이 장면은 규격 제작 측이 배포한 시험용 프로그램인 공식 로컬 참조 호스트의 삽입 화면에서 본 것이다. ChatGPT·Claude Desktop·VS Code에서 확인한 장면은 아니다. 화면, 입력 검증, 저장, AI의 다음 답, 다른 서비스에서의 작동은 서로 다른 약속이다.

    여기서 호스트란 앱 화면을 띄우고 도구 연결을 중개하는 프로그램을 뜻한다. 이 차이를 확인하려고 가상의 예시 데이터만 쓰는 최소 앱을 시험했다.

    이 글의 목차

    화면과 AI 도구를 잇는 규격

    MCP(Model Context Protocol)는 AI 호스트와 외부 도구를 연결하는 규격이다. MCP Apps는 여기에 삽입형 HTML 화면을 덧붙이는 선택 확장이다. 지원하는 호스트가 화면을 어떻게 표시할지 결정한다. 폼과 차트는 MCP 전용 부품이 아니라 일반 HTML·자바스크립트 화면이다. 구조는 2026-01-26 안정판 규격과 공식 개요에서 확인할 수 있다.

    앱에는 계산 도구와 화면용 검증·저장 도구만 넣었다. 기본 데이터는 읽기 30분, 실습 45분, 복습 15분, 합계 90분이다. 기기 권한과 외부 콘텐츠 도메인은 요청하지 않았다.

    2026년 9월 7일 Node 24.19.0, @modelcontextprotocol/ext-apps 1.7.5, MCP SDK 1.29.0으로 시험했다. 공식 로컬 참조 호스트 basic-host 1.7.5의 커밋 92f46a5를 사용했다. 빌드 검사 25개는 모두 통과했고 기록된 직접 추가 비용은 0달러였다. 이 25/25는 구현 검사일 뿐, 아래 18개 실제 동작 시험의 합격 수가 아니다.

    한영 폼은 작동했지만 결함도 있었다

    한·영 기본 합계 90분과 복습/Review를 25분으로 바꾼 합계 100분은 서버 결과·삽입 화면·화면 읽기용 텍스트와 차트에서 일치했다. 화면을 띄울 수 없다고 알린 접속 프로그램도 세 항목과 합계가 담긴 완전한 텍스트를 받았다.

    지원하지 않는 언어 코드 zz에서는 서버가 영어 대체 결과와 경고를 보냈지만 화면은 한국어를 표시하고 경고도 숨겼다. 다른 네 오류 입력은 거부했지만, 이 서버·화면 불일치 때문에 오류 입력 시험(표의 I2)은 FAIL이다. 불일치가 앱의 언어 처리와 호스트 동작 중 어디에서 비롯됐는지는 이번 시험으로 특정하지 못했다.

    저장과 AI 문맥은 따로 봐야 한다

    성공한 복원은 채팅의 기억이 아니었다. 가상의 세션 ID를 이용해 로컬 서버 프로세스 안의 저장소(server_store)에 저장한 뒤, 새 화면이 같은 ID를 보내 합계 100분을 복원했다. 서버 재시작·실제 계정·다른 기기나 호스트의 지속성은 증명하지 않는다.

    화면을 그대로 둔 채 값이 유지되는지 보려 했지만, 확인 기준이 될 바뀐 값을 서버에 만들어 두지 못했다. 닫았다 다시 열었을 때는 닫기 전에도 기본값, 다시 열 때도 기본값을 넣어서 값이 초기화된 것인지 같은 값으로 덮어쓴 것인지 구별할 수 없었다. 그래서 V1·V2는 앱 실패가 아니라 INVALID, 즉 시험은 했지만 절차 결함으로 결론을 낼 수 없는 결과다. 저장 실패 시험 S2는 시험 자체를 하지 않아 NOT TESTED다.

    화면 값, 서버 결과, 문맥 갱신 요청, AI 답은 서로 다른 통로다. Review 25분, 합계 100분 요청을 보냈다는 사실만 확인했다. 이 범위에서 C1은 PASS지만, AI 답변 성공을 뜻하지 않는다. 호스트의 수락 여부와 AI 수신·답변은 확인하지 못했으며, AI가 이 요청 때문에 값을 알았다고 말할 수 없다.

    한 번의 차단은 안전 인증이 아니다

    권한·도메인 선언은 비어 있었고, 캡처된 통신은 시험용 로컬 주소 안에 있었다. 별도로 보낸 대조 요청은 시험용 수신 지점에 도착했다. 반면 삽입 화면이 미리 허용하지 않은 같은 주소로 보낸 요청은 이 시험 환경의 콘텐츠 보안 정책(CSP, 브라우저가 화면의 외부 통신을 제한하는 규칙)에 막혀 도착하지 않았다. 이는 한 로컬 환경에서 캡처한 관찰일 뿐 안전이나 무유출 인증이 아니다. 사용자 동의 처리도 시험하지 않았다.

    18개 시험의 결과

    PASS는 적힌 범위의 기준을 충족했다는 뜻이다. FAIL은 시험했고 기준을 충족하지 못한 결과다. INVALID는 시험했지만 절차 결함으로 결론을 낼 수 없는 결과다. NOT TESTED는 시험 자체를 하지 않은 것이다. 한 행에 묶인 코드는 각각 별도 시험이다.

    표 1 · 18개 시험의 결과
    시험 결과 확인 범위
    I1 — 값 일치
    PASS
    한·영 기본값 90과 수정값 100이 서버·화면·화면 읽기용 표현에서 일치
    I2 — 오류 입력
    FAIL
    네 오류는 거부했지만 zz의 서버·화면 언어와 경고가 불일치
    V1, V2 — 화면 상태
    INVALID
    변경 상태 미생성, 기준값 재호출이라는 절차 결함으로 각각 결론 불가
    S1 — 명시적 복원
    PASS
    같은 가상 세션 ID로 프로세스 내부 서버 저장소에서 복원
    S2 — 저장 실패
    NOT TESTED
    시험 자체를 하지 않음
    C1 — 문맥 요청
    PASS(전송만)
    문맥 요청 전송만 확인; 호스트 판정과 AI 수신은 모름
    C2–C4 — AI 답과 비교
    NOT TESTED
    AI 후속 답·대조군·네 통로 전체 비교를 실행하지 않음
    P1, P2 — 권한·통신
    PASS
    빈 선언과 한 로컬 참조 환경의 CSP 차단 확인
    P3 — 사용자 동의
    NOT TESTED
    시험 자체를 하지 않음
    H0 — 참조 호스트
    PASS
    고정한 공식 로컬 참조 호스트 실행
    H1 — 실제 제품
    NOT TESTED
    실제 대화형 제품을 실행하지 않음
    A1 — 도구 노출
    PASS
    이 호스트의 호출 목록에서 화면 전용 도구가 보이지 않음
    T1 — 텍스트 대체
    PASS
    화면 기능이 없는 접속 프로그램에 완전한 한·영 텍스트 반환
    T2 — 화면 차단 대체
    INVALID
    비교 입력이 달랐다는 절차 결함으로 대체 동작 결론 불가

    합계는 PASS 8, FAIL 1, INVALID 3, NOT TESTED 6이다. C1의 PASS는 전송에만 해당한다. 앱 전용 도구가 한 호출 목록에 보이지 않았다고 해서 모든 호스트에서 권한 제한이 지켜진다는 뜻도 아니다.

    데모를 볼 때 물어볼 네 가지

    정확히 이 로컬 참조 환경에서는 양언어 상호작용, 명시적 서버 복원, 텍스트 대체가 작동했다. 언어 불일치는 이 환경에서 관찰된 실제 실패였다. 같은 화면과 닫기·재열기는 절차상 판정할 수 없었고, 저장 실패·AI 답·동의·실제 제품 호환성은 실행하지 않았다.

    화면 없이도 읽을 결과가 있는가? 누가 어디에 저장하고 어떤 ID로 복원하는가? 화면과 답이 다를 때 서버 결과를 확인할 수 있는가? 하지 않은 시험을 NOT TESTED로 남겼는가? 신뢰성은 멋진 한 번의 동작보다 서로 다른 약속을 각각 증명했는지에 달려 있다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 새로고침하면 사라지는 앱? AI가 만든 데이터 저장을 끝까지 확인해봤다

    브라우저 저장 표시와 로컬 데이터베이스가 두 개의 검증 경로로 이어진 추상 일러스트
    Grok Imagine을 사용해 생성한 AI 이미지입니다.

    저장됐다는 화면 표시만으로 정말 저장됐다고 말할 수 있을까? 화면만 바뀌었거나 이 브라우저 안에만 남았는데도 앱은 얼마든지 저장된 것처럼 보일 수 있다.

    AI로 앱을 만들거나 맡길 때 이 차이를 확인할 수 있도록, 가짜 기록만 넣은 폐기 가능한 로컬 앱 하나를 시험했다. 저장 위치만 비교하는 브라우저 화면과 기록을 만들고 지우는 핵심 앱을 같은 UI에 두고, 브라우저와 로컬 API(화면과 저장소를 잇는 통로), SQLite(파일형 데이터 저장소)를 나눠 살폈다. AI 앱 전체를 평가하는 비교는 아니다.

    1. 어디에 저장됐나?
    2. 누가 저장을 확인했나?
    3. 누가 그 데이터에 접근할 수 있나?
    이 글의 목차

    1. 어디에 저장됐나

    먼저 저장 위치만 비교하는 화면에서 기록 하나를 실행 중 메모리, sessionStorage, localStorage, IndexedDB, 그리고 일부러 값을 버리는 가짜 저장 방식에 각각 넣었다. 하드 새로고침 뒤 결과는 다음과 같았다.

    표 1 · 1. 어디에 저장됐나
    저장 방식 하드 새로고침 뒤 관찰
    실행 중 메모리
    비어 있음
    sessionStorage
    기록이 나옴
    localStorage
    기록이 나옴
    IndexedDB
    기록이 나옴
    값을 버리는 방식
    비어 있음

    공식 문서에 따르면 sessionStorage는 탭 세션 동안 유지되고, localStorage는 같은 출처의 브라우저 세션을 넘어 남을 수 있다. IndexedDB는 브라우저 쪽 구조화 저장소다. 따라서 이번처럼 “새로고침 후 보인다”는 관찰만으로는 서버 저장이나 다른 기기 복구를 증명할 수 없다. 브라우저 저장소도 삭제·축출될 수 있다(MDN 저장 용량과 축출 기준).

    이번 브라우저 확인은 하드 새로고침까지만 했다. 브라우저 프로세스를 완전히 종료한 뒤 재시작하는 검사와 깨끗한 새 프로필에서의 UI 검사는 실행하지 않았다. 이 두 UI 검사는 아래의 검증기 25개 체크포인트와 별개이며, 성공이나 실패로 판정하지 않았다.

    2. 누가 저장을 확인했나

    핵심 앱에서는 가짜 사용자 A가 기록 세 개를 만들고, 하나를 수정하고, 하나를 삭제했다. 앱의 응답만 믿지 않고 별도 검증기가 SQLite 파일을 직접 읽어 예상한 ID·내용·버전과 비교했다. 로컬 API가 캐시를 쓰지 않는다는 응답(Cache-Control: no-store)과 SQLite에서 읽었다는 자기표시(read_source: sqlite_authoritative)도 받았지만, 이 표시 자체를 증거로 삼지는 않았다. API 결과가 독립적인 SQLite 직접 검사와 일치하는지 다시 대조했다.

    실행은 세 번이었다. 첫 실행은 제한 환경이 로컬 포트 연결을 막아 2 PASS·20 FAIL·2 INVALID·1 NOT RUN을 남겼다. 두 번째는 서버 프로세스가 첫 요청 전에 종료되어 3 PASS·21 FAIL·1 NOT RUN이었다. 두 번 모두 앱 품질 판정에서 제외했다. 환경과 프로세스 운영 실패를 숨기지 않고 보존한 뒤, 미리 정해 바꾸지 않은 같은 검사 순서를 정상 로컬 환경에서 실행한 세 번째만 앱 관찰값으로 사용했다.

    세 번째 유효 실행의 기계 판정은 24 PASS, 0 FAIL, 0 INVALID, 1 NOT RUN이었다. 이는 기능 완성도 점수가 아니라 생성·수정·삭제, 직접 읽기, 서버 불가 상태의 부정 확인, 접근 차단 등을 포함한 25개 체크포인트의 합계다. 여기서 1 NOT RUN은 로컬 코드 아티팩트 교체 한 항목이다.

    서버가 응답하지 않을 때는 권위 있는 읽기도 실패했고, 서버가 돌아온 뒤 다시 읽을 수 있었다. 이는 서버가 꺼진 동안의 응답을 저장 확인으로 잘못 세지 않았다는 오프라인 부정 확인이며, 모든 캐시 상황을 시험했다는 뜻은 아니다. 별도의 로컬 서버 프로세스 재시작 검사에서는 다른 프로세스로 다시 띄운 뒤에도 같은 SQLite 기록이 유지됐다.

    그러나 코드 아티팩트 교체와 호스팅 배포는 실행하지 않았다. 로컬 서버 재시작을 배포 성공이라고 부를 수는 없다. 클라우드 내구성, 백업 복원, 장기 보존도 이번 결과의 범위 밖이다. 이번 로컬 실행의 직접 금전 비용은 USD 0.00이었으며, 구독·노동·전기·장비 비용을 계산한 값은 아니다.

    3. 누가 접근할 수 있나

    저장이 오래 남아도 다른 사람이 볼 수 있다면 성공이라 하기 어렵다. 이 실험은 고정된 테스트 헤더 X-Synthetic-Identity로 가짜 사용자 A와 B를 구분했다. B가 자기 기록을 만드는 정상 경로를 먼저 통과한 뒤, A가 만든 기록의 ID를 읽고·수정하고·삭제하도록 요청했다. 해당 요청들은 404(찾을 수 없음)로 거부됐고 저장소의 A 기록도 바뀌지 않았다. 테스트 헤더를 빼고 보낸 읽기는 401(인증 필요), A가 B의 기록을 읽는 반대 방향 요청은 404였다.

    이는 테스트한 경로에서만 사용자 분리가 작동했다는 뜻이다. 고정 헤더로 사용자를 구분한 로컬 장치라 실제 로그아웃 상태를 시험한 것이 아니며, 운영 인증이나 제품 보안을 증명하지 않는다. Supabase의 행 수준 보안 안내와 Firebase 보안 규칙 문서도 로그인과 데이터 권한을 별개로 다룬다.

    중복도 별도 항목이다. 같은 작업 ID로 A의 생성 요청을 딱 한 번 다시 보냈을 때 기록은 하나로 유지됐다. 이것은 그 한 가지 재시도만 통과했다는 관찰이지, 모든 중복이나 동시 요청이 안전하다는 보장이 아니다. 저장 유지, 중복 재시도, 사용자 분리는 서로 대신할 수 없는 세 결과다.

    저장 완료 표시보다 먼저 물을 것

    비개발자가 AI로 앱을 만들 때는 다음 세 질문을 그대로 사용할 수 있다.

    • 어디에 저장됐나: 화면이나 이 브라우저에만 남은 것인지, 서버 저장소까지 간 것인지 구분해 달라고 요청했는가?
    • 누가 저장을 확인했나: 앱의 완료 표시가 아니라 저장소를 직접 읽은 결과도 보여 달라고 요청했는가? 새로고침·브라우저 재시작·서버 재시작·코드 교체·배포 중 실제로 넘은 경계도 구분했는가?
    • 누가 접근할 수 있나: 허용 사용자뿐 아니라 거부되어야 할 사용자도 시험했는가?

    이번 로컬 앱에서는 제한된 생성·읽기·수정·삭제, 한 번의 동일 작업 재시도, 선택한 사용자 분리 경로, 오프라인 부정 확인, 로컬 서버 프로세스 재시작이 예상과 맞았다. 그보다 넓은 결론은 내리지 않는다. 화면의 완료 표시보다 강한 증거는, 어디에 남았고 누가 확인했으며 누가 볼 수 없는지를 경계별로 기록한 결과다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 2026년 바이브코딩 도구 선택법: 목적별로 먼저 확인할 것

    2026년 바이브코딩 도구 선택법: 목적별로 먼저 확인할 것

    노트북의 추상 대시보드를 돋보기로 확인하고 세 단계 검증 칸을 통과시키는 편집 일러스트
    위험 범위, 대조할 답, 내보내기라는 세 가지 질문을 표현한 그림입니다. Grok Imagine을 사용해 생성한 AI 이미지입니다.

    보기 좋은 화면과 맞는 결과는 다를 수 있다. USGS 공개 CSV로 만든 대시보드의 첫 화면에는 필터와 카드, 차트와 표가 모두 있었다. 그러나 저장한 파일의 지진 2,274건 가운데 규모 값이 2.5 미만인 행이 17건 있었고, 화면은 ‘규모 2.5 이상’이라고 설명하면서 2,274건을 전부 표시했다. 미리 계산해 둔 기본 조건의 답은 2,257건이었다. 자연어 수정 한 번 뒤에야 화면과 검산값이 일치했다.

    이 사례가 도구 선택의 출발점이다. 가장 빨리 만들어 주는 제품을 찾기 전에, 내가 만들려는 결과를 어떻게 확인할지부터 정해야 한다. 이 글에서 바이브코딩은 원하는 기능을 자연어로 설명하고 AI가 코드를 만들고 고치게 하는 방식을 뜻한다.

    아래 선택표는 아홉 주제의 기록을 목적별로 다시 묶은 것이다. 같은 과제를 여러 도구에 준 비교는 AI 구독 답변과 PPTX 자동화 앱뿐이었다. 나머지는 서로 다른 입력, 환경, 완료 기준을 사용한 단일 사례다. 따라서 시간·수정 횟수·성공 여부를 합산해 종합 순위를 만들 수 없다. Codex는 OpenAI의 코딩 에이전트다. 이 시리즈에서는 일부 결과물을 만드는 도구이면서, 실제 초보 참가자 대신 정해진 절차로 화면 조작과 검증을 수행한 운영자이기도 했다. 합성 입력은 실제 자료를 흉내 내 만든 가짜 샘플을 뜻한다.

    이 글의 목차

    한눈에 보는 목적별 선택표

    표 1 · 한눈에 보는 목적별 선택표
    하려는 일 실제로 검증한 범위 관찰된 결과 내 과제에서 더 확인할 것 관련 편
    작은 개인용 로컬 도구
    준비된 Mac에서 Codex로 할 일·Mac Calendar 전달 앱 1개 제작
    첫 구현과 브라우저 확인까지 약 6분. 같은 생성 흐름의 자동 테스트 8개 통과
    설치·인증 시간, 실제 휴대폰, 삭제 화면, 내보낸 폴더 재실행
    01편
    Excel 반복 정리
    Claude가 만든 첫 코드와 Codex 수정본으로 합성 Excel 100개에서 값 추출
    수정 뒤 83개 자동 확정, 17개 검토 필요
    원본 복사, 출처 셀, 누락·중복·결측 규칙, 실제 파일 변형
    05편
    반복 파일 분류
    Cursor로 합성 파일 10개를 미리보기 실행·실제 실행·재실행
    분류 위치와 내용 대조를 통과했고 재실행 추가 이동 0건
    폴더 범위, 중복 이름, 위험 표시, 실제 파일 복사본
    07편
    호스팅형 빌더로 파일 처리 앱 만들기
    Lovable·Bolt·Replit에 같은 합성 PPTX 과제 제공
    세 결과 모두 20장과 111개 문구를 보존했지만, 모두 가독성 문제가 남음
    앱 코드의 GitHub·ZIP 내보내기와 타 환경 재실행, 모바일·로그아웃 상태
    03편
    웹사이트 빠른 시안
    v0 실험 절차만 준비
    관찰 결과 없음. 기존 로그인 세션이 없어 프롬프트 전송 전에 중단
    실제 생성 품질, 크레딧 소모, 모바일, 배포, 코드 이동
    06편
    공개 데이터 대시보드
    Codex로 고정한 USGS CSV 한 개의 정적 로컬 앱 제작
    첫 화면의 기본 범위가 설명과 달랐고, 자연어 수정 1회 뒤 2,257건으로 검산 통과
    현재 데이터와의 차이, 정답 조합, 오류 파일, 시간대·결측, 접근성, 외부 요청
    09편
    로그인·개인정보가 있는 앱
    Codex로 합성 로컬 메모 앱의 회원가입·로그인과 제한된 보안 점검
    기능 테스트 4개는 통과했지만 반복 오입력 차단 없음, 응답시간 차이, 기본 관리자 비밀번호 등이 남음
    권한·세션·웹 보안 항목인 CSRF·XSS·비밀 관리와 전문가 검토. 결제는 이번에 시험하지 않음
    04편
    기존 앱에 기능 추가
    Codex로 별도 앱 Pocket Tasks에 우선순위·마감일·제목 편집 추가
    실행한 검사에서 기존 기능 깨짐 0건, 테스트 7→18개. 코드와 재검사 범위 증가
    복원점, 전체 회귀 검사, 손상 저장값, 삭제 동작, 되돌리기
    08편
    구독·요금제 고르기
    기본 모드가 다른 ChatGPT·Claude·Grok에 같은 구매 질문과 재검증 질문 제공
    세 첫 답변 모두 오류나 과장이 있었고 공식 원문 재확인 뒤 개선
    현재 지역 가격, 포함 기능, API 과금, 실제 사용 한도
    02편

    이 표의 ‘관련 편’은 각 관찰의 자세한 조건을 담은 글 번호다. 넷째 열은 이 실험의 미확인 목록이 아니라 독자가 자기 과제에서 다시 확인할 항목이다. 제품 전체의 성능표가 아니며, 검증하지 않은 용도까지 추천하는 표도 아니다. 웹사이트 빠른 시안 행에는 실행 결과 자체가 없다.

    선택 순서는 세 질문부터 시작한다

    첫째, 로그인·결제·다른 사람의 정보가 들어가는가? 그렇다면 프로토타입이 작동하는 것과 실제 운영이 안전한 것은 별개의 단계다. 로그인 앱 사례에서는 가입과 로그인이 되었고 생성된 기능 테스트도 통과했다. 그러나 별도 점검에서는 반복 시도 제한, 계정 존재를 짐작하게 할 수 있는 응답시간 차이, 기본 관리자 비밀번호 같은 문제가 드러났다. 결제는 시험하지 않았으므로 이 결과를 결제 앱의 안전성 판단으로 확대할 수 없다.

    둘째, AI의 설명과 별개로 대조할 답이 있는가? 정답표는 복잡한 테스트 코드일 필요가 없다. 원본 파일 수와 파일이 바뀌지 않았는지 확인하는 고유값(해시), 손으로 계산한 샘플 세 줄, 열어 본 슬라이드 한 장, 공식 페이지의 현재 가격도 답이 된다. 대시보드의 2,274와 2,257 차이도 사전에 계산한 값이 있었기 때문에 발견했다.

    셋째, 코드와 데이터를 꺼내 다시 실행할 수 있는가? ‘코드는 사용자 소유’라는 문구와 실제 이동 가능성은 다르다. 이번 호스팅형 빌더 실험에서는 결과 PPTX는 내려받았지만 앱 코드 전체의 GitHub·ZIP 내보내기와 다른 환경 재실행은 시험하지 않았다. 확인하지 않은 이동성을 장점으로 계산해서는 안 된다.

    세 질문 중 하나라도 답하기 어렵다면 더 비싼 도구를 고르기 전에 과제를 줄이는 편이 안전하다. 실제 자료 대신 복사본이나 작은 합성 샘플을 쓰고, 맞아야 할 값 하나를 적고, 첫 결과를 보존하는 식으로 시작할 수 있다.

    작은 로컬 도구 한 건은 확인된 첫 버전에 빠르게 도달했다

    준비된 개발 환경에서 만든 로컬 할 일 앱은 첫 요청 뒤 약 6분 만에 주요 브라우저 확인까지 도달했다. 할 일을 추가하고 완료로 바꿀 수 있었고, 새로고침 뒤에도 내용이 남았다. Calendar 새 일정 화면에는 제목과 시간이 채워졌다. 자동 테스트 8개도 통과했다.

    그러나 약 6분은 설치와 인증이 이미 끝난 Mac에서 Codex가 조작한 한 번의 기록이다. 삭제 버튼의 실제 화면 클릭과 실기기 모바일 사용은 끝까지 확인하지 못했다. 이 수치는 ‘초보자도 6분’이라는 약속이 아니다. 낮은 위험의 합성 입력을 사용했고, 확인할 동작이 작았기 때문에 빠른 후보가 됐다는 관찰이다.

    자동화가 끝나도 예외와 검토는 남았다

    Cursor 파일 정리 실험은 합성 파일 10개로 먼저 이동 예정표만 보는 미리보기 실행(dry run)을 했다. 실제 이동 뒤에는 분류 위치와 파일 내용이 바뀌지 않았는지 대조했고, 같은 명령을 다시 실행했을 때 추가 이동은 0건이었다. 생성 코드는 이 제한된 과제를 수정 없이 통과했다. 다만 폴더 접근 범위, 중복 이름 처리, 위험 표시 해석은 사람이 정해야 했다.

    Excel 100개 실험에서는 91개에 정상값이 있었고, 4개에는 값이 없었으며, 5개에는 후보가 중복됐다. 첫 후보는 정상값 60개를 정확히 찾았지만 31개를 놓쳤고 차트도 빠졌다. 규칙과 차트를 보완한 뒤 83개를 자동 확정했으며, 나머지 17개는 검토 대상으로 남았다. 스크립트 자체는 1초 미만에 실행됐지만 사람의 100개 수작업 시간과 전체 요구 정리·수정·검산 시간을 재지 않았다. ‘사람보다 몇 배 빠르다’는 결론은 낼 수 없다.

    여기서 도구보다 중요한 것은 결과가 원본 파일·시트·셀로 되돌아갈 수 있는지, 누락·중복·결측이 검토 목록으로 분리되는지다. 입력 형식이 제각각이고 정답 샘플이 없다면 빠른 실행은 품질을 보장하지 않는다.

    유효한 파일과 바로 쓸 수 있는 파일은 달랐다

    Lovable·Bolt·Replit에는 같은 합성 PPTX 두 개와 같은 요구를 보냈다. 세 도구 모두 최종적으로 20장과 111개 문구를 보존한 유효한 파일을 만들었다. 하지만 세 출력 모두 글자와 배경의 대비가 부족하거나 내용이 보이지 않는 슬라이드가 남아 일관된 가독성 기준에는 미달했다.

    이는 PPTX 포맷 통일이라는 한 과제의 결과다. 세 서비스의 웹사이트 제작 품질이나 일반적인 우열을 뜻하지 않는다.

    웹사이트 시안 실험에는 실행 결과가 없다

    v0로 랜딩 페이지를 만드는 별도 실험은 로그인 전에 중단됐기 때문에 생성 품질, 크레딧 소비, 모바일 화면, 공개 배포에 관해 관찰한 결과가 없다. 공식 문서에 기능이 있다는 사실을 실험 성공으로 바꾸지 않는다.

    데이터 화면은 차트보다 숫자 관계를 먼저 고정해야 했다

    USGS 피드에서 저장한 파일은 2,276행이었고, 이 가운데 지진은 2,274행이었다. 피드 이름은 M2.5+였지만 고정 스냅샷에는 저장된 규모 값이 2.5 미만인 지진 17행이 있었다. 단일 스냅샷만으로 그 값의 이전 버전이나 수정 이력까지 확인한 것은 아니다. 첫 화면은 최소 규모 값을 비워 둔 채 2,274건을 모두 보여 주면서 ‘2.5 이상’이라고 설명했다. 자연어로 초기 최소 규모와 초기화 값을 2.5로 맞춘 뒤 기본 건수는 2,257건이 됐고 사전 계산과 일치했다.

    수정 뒤에는 다섯 필터 조합, 오류 파일, 375×812 화면, 키보드 조작, 내보낸 폴더 재실행을 확인했다. 브라우저 관찰에서는 로컬 주소 127.0.0.1 밖으로 나간 요청이 없었다. 이는 정적 앱 한 개의 제한된 네트워크 관찰이지 Codex나 다른 공급사의 개인정보 처리 점수가 아니다. USGS 피드는 계속 바뀌므로 같은 URL의 현재 값과 이 고정 스냅샷도 구분해야 한다.

    유지보수는 새 기능보다 다시 확인할 범위가 늘어났다

    별도 앱 Pocket Tasks에는 우선순위, 마감일, 제목 편집을 차례로 추가했다. 자동 테스트는 7개에서 18개로 늘었고, 실제로 실행한 검사에서는 기존 기능이 깨지는 회귀를 발견하지 못했다. AI에 보낸 수정 요청도 0회였다.

    그렇다고 유지보수가 쉽다는 뜻은 아니다. 빈 줄을 뺀 앱 코드는 214줄에서 361줄, 테스트는 37줄에서 123줄로 늘었다. 삭제 동작 일부와 손상된 저장값을 화면에 직접 넣는 검사는 반복하지 못했다. 이 사례가 보여 준 것은 테스트가 이전 동작을 반복해서 확인할 경로를 제공했다는 점과, 기능이 늘수록 검증 표면도 커진다는 점이다.

    가격은 순위가 아니라 발행일의 조건이다

    구독 질문 실험에서도 기본 모드가 서로 다른 ChatGPT·Claude·Grok의 첫 답변 모두에 오류나 과장이 있었고, 공식 원문을 다시 확인한 뒤에야 개선됐다. 그래서 가격 정보는 AI 답변이 아니라 2026년 9월 6일 다시 확인한 공식 페이지를 기준으로 삼았다. 여러 무료 시작 경로가 있었지만 서비스마다 무료 사용량 단위가 빌드 크레딧, 토큰, 에이전트 크레딧, 메시지 수로 달라 서로 환산할 수 없다. 추가 결제 0원으로 실험했다는 사실도 모든 독자가 무료로 같은 결과를 얻는다는 뜻이 아니다.

    결제하거나 공개 발행하기 직전에는 ChatGPT, Claude, Grok, Lovable, Bolt, Replit, v0, Cursor의 현재 공식 페이지를 다시 확인해야 한다. USGS 데이터의 필드와 갱신 조건은 USGS CSV 문서, 로그인 보안의 출발점은 OWASP Authentication Cheat Sheet와 NIST SP 800-63B에서 확인할 수 있다.

    결론: 제품보다 먼저 멈출 기준을 고르자

    아홉 주제는 하나의 최고 도구를 가리키지 않았다. 대신 낮은 위험의 작은 과제에서는 합성 입력과 독립적인 정답이 있을 때 첫 결과가 빠르게 실제 도구 후보가 될 수 있음을 보여 줬다. 반대로 화면이 완성처럼 보여도 숫자, 가독성, 권한, 보안, 내보내기, 유지보수는 따로 확인해야 했다.

    시작할 때는 다음 여섯 단계로 시작할 수 있다.

    1. 실제 자료 대신 복사본이나 작은 합성 샘플을 넣는다.
    2. 맞아야 할 숫자·문구·동작 하나를 먼저 적는다.
    3. 첫 결과를 덮어쓰지 않고 보존한다.
    4. 결과 파일이나 코드를 도구 밖으로 꺼내 실제 프로그램에서 연다.
    5. 같은 입력으로 다시 실행하고 결과가 유지되는지 본다.
    6. 로그인·타인의 정보·결제처럼 위험이 큰 기능인데 대조할 답이 없다면 범위를 줄이거나 전문가 검토를 받는다.

    이것은 실제 초보자 집단에서 검증한 완전한 안전 절차가 아니다. 이 시리즈가 그럴듯한 결과와 확인된 결과를 구분하기 위해 사용한 출발점이다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 공개 CSV로 대시보드 만들기, 코딩 없이 어디까지 가능할까?

    공개 CSV로 대시보드 만들기, 코딩 없이 어디까지 가능할까?

    CSV 파일 하나를 AI에게 주면 대시보드가 바로 완성될까? 이번에는 조건을 최대한 좋게 잡았다. 미국 지질조사국(USGS)이 제공하는 ‘최근 30일 규모 2.5 이상 지진’ CSV를 내려받아, 필터·요약 카드·차트·표가 있는 로컬 대시보드를 자연어로 만들었다.

    공개 CSV의 데이터가 세 단계 검증을 거쳐 차트로 정리되고 범위 밖 값 하나가 분리되는 모습
    공개 데이터를 대시보드로 바꾸기 전에 검증과 수정이 필요하다는 과정을 표현한 대표 이미지. Grok Imagine을 사용해 생성한 AI 이미지입니다.

    먼저 분명히 할 점이 있다. 이것은 실시간 지진 모니터링이나 경보·안전 판단 도구가 아니다. 2026년 9월 4일에 저장한 30일 이동 구간의 고정 스냅샷을 보는 실험이다. 공식 피드는 매분 갱신되므로 같은 URL의 내용은 달라질 수 있다. USGS는 이 CSV를 스프레드시트 분석에 적합한 형식으로 설명하며 필드 정의를 공개한다. USGS 제작 정보는 미국 내 퍼블릭 도메인으로 안내되지만, 출처 표기는 요청한다.

    이 글의 목차

    “코딩 없이”의 기준부터 정했다

    무코드를 넓게 잡으면 무엇이든 성공으로 만들 수 있다. 그래서 운영자가 할 수 있는 행동을 먼저 고정했다. 자연어 프롬프트를 보내고, 자연어로 증상을 설명하고, 생성된 폴더를 복사하고, README의 실행 명령을 그대로 쓰는 것까지 허용했다. 소스 코드를 열거나 직접 고치고, 함수명이나 줄 번호를 지목하면 무코드 실패다.

    이번 조작 경로는 Codex가 수행했다. 인간 비개발자가 직접 써 본 사용성 실험은 아니다.

    정확성 검사는 별도였다. 앱을 만들기 전에 포함할 행, 결측치 처리, 필터의 이상·이하 조건, UTC 날짜, 규모 구간, 반올림, 빈 결과 표시를 ‘정답표’로 고정했다. 앱 코드와 연결하지 않은 Python 검산기로 다섯 가지 필터 조합을 계산했다. 검산기는 작성자까지 독립적이지 않으므로 ‘독립 검증’이라고 과장하지 않았다.

    첫 화면은 멀쩡했지만, 의미가 틀렸다

    Codex CLI 0.149.0의 gpt-5.6-sol에 사전 조건을 자세히 적은 한 번의 자연어 요구를 보내자 약 5분 뒤 HTML·CSS·JavaScript·README가 만들어졌다. 설치 패키지나 외부 차트 라이브러리는 없었다. CSV는 로컬에서 읽었고, 쉼표가 든 위치 텍스트도 깨지지 않았다. 필터 네 개, 요약 네 개, 차트 두 개, 표까지 처음부터 동작했다.

    그런데 첫 결과에는 꽤 중요한 오류가 있었다. 화면은 “2.5 이상”이라고 쓰면서 최소 규모 기본값은 비어 있었다. 그 결과, 유형만 지진으로 정리한 2,274행을 전부 보여 줬다. 보기 좋은 화면과 의미상 맞는 화면은 달랐다.

    세 숫자는 서로 다른 처리 단계를 뜻한다.

    1. 2,276행 — 저장한 CSV 전체: 지진 2,274행과 산사태(landslide) 2행이 들어 있었다.
    2. 2,274행 — 유형 정리 뒤: 산사태 2행을 빼고 type=earthquake인 행만 남긴 수다. 최초 화면은 여기까지 적용했다.
    3. 2,257행 — 수정된 기본 필터 뒤: 지진 2,274행 가운데 저장 시점의 규모가 2.5 미만인 17행을 mag >= 2.5 조건으로 더 제외한 수다.

    즉 2,276 - 2 = 2,274, 다시 2,274 - 17 = 2,257이다. 앞의 2건은 지진이 아닌 자료를 유형으로 정리한 것이고, 뒤의 17건은 지진이지만 저장된 규모가 기본 표시 기준 아래여서 필터링한 것이다. 피드 이름이 ‘M2.5+’여도 저장 시점의 각 행이 모두 2.5 이상이라고 가정할 수 없었다.

    “초기 최소 규모와 초기화 값을 2.5로 맞춰 달라”는 자연어 수정 한 번을 보냈다. 코드 파일은 열지 않았다. 수정 뒤 기본 건수는 2,257건으로 검산값과 일치했다. 첫 생성은 부분 성공, 최종 결과물은 자연어 수정 1회 뒤 성공으로 판정했다.

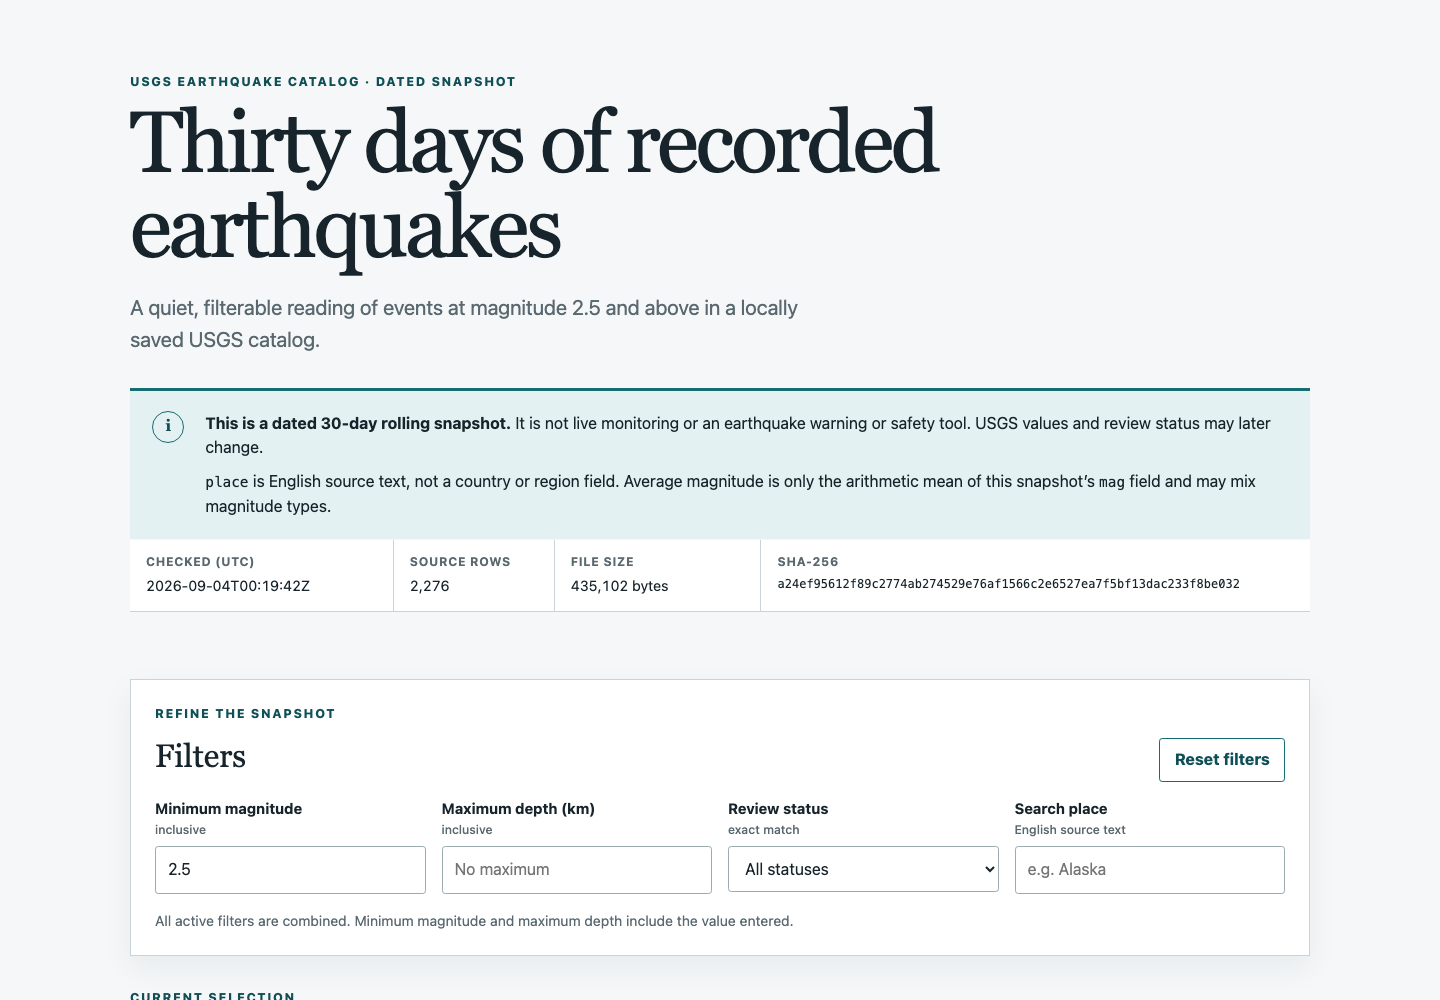
    USGS 공개 CSV를 불러와 지진 건수와 규모·깊이 요약, 차트, 표를 보여 주는 최종 로컬 대시보드
    자연어 수정 1회 뒤의 최종 화면. 2026년 9월 4일 저장본에 최소 규모 2.5 기본 필터를 적용한 2,257건을 보여 준다. 최소 규모 기본값이 비어 2,274건을 보여 준 최초 실패 화면은 이 이미지가 아니다.

    숫자는 어디까지 맞았나

    사전 등록한 다섯 조합에서 건수, 평균 규모, 최대 규모, 평균 깊이, 규모 구간, UTC 일별 합계가 모두 검산기와 같았다. 대표 조합의 건수는 다음과 같았다.

    • 규모 4.5 이상: 651건
    • 규모 3.0 이상·깊이 70km 이하·reviewed 상태: 1,195건
    • 위치 텍스트에 Alaska 포함: 855건

    평균 규모는 USGS CSV의 규모 유형 필드인 magType 9종이 섞인 mag 값의 단순 산술평균일 뿐 에너지나 피해의 평균이 아니다.

    위 건수는 모두 2026년 9월 4일 저장본 기준이며 현재 공식 피드와 다를 수 있다. 어떤 값도 안전 판단의 근거로 쓰면 안 된다.

    테스트 자동화가 앞 조합의 reviewed 상태와 최대 깊이 값을 지우지 못한 채 Alaska 조합을 실행해 756을 표시한 적이 있었다. 앱의 Reset으로 초기화한 뒤 다시 실행하자 정답 855와 일치했다. 이를 앱 계산 오류가 아니라 테스트 상태 초기화 오류로 기록했다.

    최소 규모를 9.9로 바꾸면 건수는 0, 평균과 최대값은 숫자 0이 아니라 ‘—’로 표시됐다.

    별도로 만든 시험 파일에서는 규모가 잘못되거나 깊이가 빈 행을 앱이 제외하고, 제외 건수를 화면에 알렸다. 헤더만 있는 파일, 필수 헤더 누락, 파일 404는 빈 화면 대신 원인을 담은 오류를 보여 줬다. 375×812 화면에서 페이지 가로 넘침은 없었고, 키보드로 필터와 초기화 버튼에 접근할 수 있었으며 포커스 표시도 보였다. 차트의 모든 값은 표로도 제공됐다. 다만 이것은 최소 접근성 점검이지 웹 콘텐츠 접근성 지침(WCAG) 준수 인증은 아니다.

    최종 폴더는 터미널에서 README의 Python 로컬 HTTP 서버 명령을 그대로 실행해 다시 열었고 외부 네트워크 요청은 0건이었다. 즉 소스 편집은 없었지만, 호스팅까지 GUI로 끝나는 일반적인 무코드 서비스는 아니었다.

    추가 결제는 없었지만 기존 ChatGPT Pro/Codex 구독을 사용했으므로 ‘무료’라고 부를 수는 없다.

    생성 약 5분, 검증 약 8분, 수정 약 30초로 전체 실험은 약 14분이 걸렸다. 조사와 앞선 편집 인터뷰 시간은 포함하지 않았다.

    결론: 화면 제작보다 검증 규칙이 더 중요했다

    공식 설명이 잘 갖춰진 CSV 한 개, 이 Codex 모델, 정밀한 최초 프롬프트라는 조건에서는 코드를 직접 읽지 않고도 실제 동작하는 대시보드까지 갈 수 있었다. 첫 생성부터 대부분의 기능이 작동했고 자연어 수정도 한 번이면 충분했다.

    하지만 “CSV를 넣으면 끝”은 아니었다. 가장 위험한 오류는 앱이 멈추는 오류가 아니라, 멀쩡한 화면이 데이터 설명과 다른 범위를 보여 주는 오류였다. 다음 세 묶음을 먼저 정하지 않았다면 놓쳤을 가능성이 크다.

    • 출처·이용 조건과 고정 스냅샷
    • 계산 규칙·빈 값과 시간대
    • 모바일·키보드와 오류 상태

    자신의 공개 CSV에 적용하려면 네 가지를 먼저 확인하는 편이 좋다. 재사용 조건이 명확한가, 시간·숫자·범주 열의 뜻이 정의돼 있는가, 실시간 API가 아닌 고정 입력으로 재현할 수 있는가, 정답을 대조할 작은 필터 조합을 만들 수 있는가. 이 조건이 없다면 멋진 차트보다 검증 비용이 먼저 커진다.

    이번 결과는 문서가 잘 된 USGS CSV 한 개의 최상 조건 실험이다. 다른 공개 데이터, 실시간 연결, 지도, 재난 판단 도구까지 된다는 뜻은 아니다. 그래도 한 가지는 분명했다. AI는 대시보드의 화면과 계산을 빠르게 만들 수 있다. ‘제대로 작동한다’고 말하려면 검증 규칙과 근거를 별도로 정하고 확인해야 한다.

    출처

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 기능을 세 번 더한 뒤, 바이브코딩 앱의 예전 동작은 그대로였을까?

    기능을 세 번 더한 뒤, 바이브코딩 앱의 예전 동작은 그대로였을까?

    우선순위 다이얼, 달력 보드, 연필 모듈이 연결된 유지보수 기계
    우선순위·날짜·편집 기능이 맞물리는 유지보수를 표현한 일러스트입니다. Grok Imagine을 사용해 생성한 AI 이미지입니다.

    새 기능을 넣은 뒤 필터를 바꿀 때 완료·미완료를 합친 전체 건수가 틀어지거나, 새로고침 뒤 저장한 내용이 사라진다면 어떨까? 개발자는 이런 일을 ‘회귀’라고 부른다. 비개발자에게는 한 곳을 고쳤는데 전에 되던 다른 곳이 고장 난 것이라고 이해하면 충분하다.

    로컬 할 일 앱 하나에 우선순위, 마감일, 제목 편집을 차례로 추가했다. 이번 실행에서는 실제로 수행한 자동 검사와 화면 확인 범위 안에서 새 기능 오류나 기존 기능 회귀를 발견하지 못했고, AI에 수정 요청도 보내지 않았다. 다만 이 결과에는 조건이 있다. 기준 앱부터 테스트와 저장 오류 처리를 요청했고, 매번 실행한 검사가 통과한 버전에서 다음 단계를 시작했다. 계획한 화면 검사를 전부 실행한 것도 아니어서 네 단계 모두 ‘부분 확인’으로 판정했다.

    이 글의 목차

    먼저 가져갈 결론

    • 이번 한 사례에서는 기능 세 개를 추가한 뒤에도 실행한 검사가 모두 통과했다.
    • ‘오류 0’은 앱 전체가 안전하다는 뜻이 아니라 수행한 검사에서 오류를 찾지 못했다는 뜻이다.
    • 이번 사례에서는 기능과 함께 코드·테스트·다시 확인할 항목도 늘었다. 이 결과는 새 기능을 맡긴 뒤 예전 동작과 저장 상태를 함께 재검사하는 습관을 뒷받침한다.

    이 한 사례에서 가져갈 실용적인 판단 기준은 “AI가 첫 코드를 만들어줬는가”에 그치지 않는다. 새 기능을 넣을 때마다 같은 확인 순서를 반복할 수 있는가도 함께 봐야 한다.

    기능을 추가할 때 다시 볼 다섯 가지

    1. 새 기능보다 먼저 예전 버튼을 같은 순서로 다시 누른다.
    2. 필터를 바꾼 뒤 목록과 전체 건수가 어긋나지 않는지 본다.
    3. 새로고침하거나 다시 열어 입력한 데이터가 남는지 확인한다.
    4. 새 기능이 완료 상태나 날짜처럼 관계없는 값까지 바꾸지 않았는지 살핀다.
    5. 문제가 생기면 구체적으로 다시 요청하고 처음부터 전체 순서를 반복한다.

    이번에는 수정 요청이 필요하지 않았지만, 마지막 항목도 실험 전에 미리 정해 둔 대응 절차였다. 결과를 보고 나서 유리하게 만든 규칙은 아니다.

    로컬 할 일 앱을 네 단계로 바꿨다

    외부 서버나 실제 개인정보가 없는 로컬 앱 ‘Pocket Tasks’를 AI 코딩 도구 Codex로 만들었다. 도구 화면에 정확한 모델명이 표시되지 않아 이 글에서는 모델명을 적지 않는다. 기준 앱 요청에는 할 일 추가·완료·삭제, 상태 필터, 전체·진행 중·완료 건수 요약, 브라우저 저장 기능과 함께 단위 테스트와 저장 오류 처리를 처음부터 포함했다.

    그 뒤에는 직전 단계에서 실행한 검사가 통과한 스냅숏, 즉 그 시점의 저장된 버전만 이어받아 기능을 하나씩 추가했다.

    • S0: 기준 앱
    • S1: 우선순위와 상태·우선순위 결합 필터
    • S2: 마감일과 ‘기한 지남’ 필터
    • S3: 목록 안에서 제목 편집

    각 단계에서는 JavaScript 문법을 확인했다. S1부터는 이전 단계의 자동 테스트를 고치지 않은 채 전부 다시 실행하고 새 기능 테스트를 더했다. 화면 확인은 브라우저 도구로 진행했다. 추가·완료·필터·요약을 다시 확인했으며, 새로고침 때는 그 단계까지 존재한 제목·완료 상태·우선순위·날짜가 남는지 살폈다.

    실행한 검사에서는 회귀를 찾지 못했다

    표 1 · 실행한 검사에서는 회귀를 찾지 못했다
    단계추가 기능자동 테스트판정
    S0
    기준 앱
    7/7 통과
    부분 확인
    S1
    우선순위·결합 필터
    10/10 통과
    부분 확인
    S2
    마감일·기한 지남
    15/15 통과
    부분 확인
    S3
    목록 안 제목 편집
    18/18 통과
    부분 확인

    제품 오류는 새 기능 자체의 문제, 회귀는 이전에 되던 기능이 깨진 문제로 셌다. 네 단계에서 수행한 검사 기준 제품 오류는 0건이었고, S1~S3에서 관찰된 회귀도 0건이었다. AI에 보낸 수정 요청도, 검증 뒤 사람이 직접 코드를 고친 일도 0회였다.

    화면 확인도 기능이 추가된 단계별로 나눴다. S1에서는 우선순위 기능이 생기기 전에 만든 할 일이 요청한 대로 중간 우선순위로 표시됐다. S2에서는 상태·우선순위·기한 조건을 모두 만족하는 항목만 남도록 필터가 함께 작동했고, 화면에 일부 항목만 보여도 전체 건수 요약은 바뀌지 않았다. S3에서는 제목을 편집해도 완료 여부·우선순위·마감일이 유지됐고, 새로고침 뒤에도 저장한 값이 남았다. 이 확인 과정에서 생긴 검사 도구 문제는 아래에서 설명한다.

    자동 검사는 Node.js의 내장 테스트 러너를 사용했다. 테스트 중 예외가 생기면 실패로 표시된다. 브라우저 데이터는 같은 출처(origin)에 값을 보존하는 localStorage에 저장했다. 자동 테스트로 확인한 상태·저장 로직과 별도로, 브라우저에서 실제 새로고침 뒤 값이 남는지도 확인했다. (Node.js Test Runner, MDN Web Storage API)

    왜 네 단계 모두 ‘부분 확인’인가

    사용한 브라우저 도구로는 저장소 값을 직접 바꿀 수 없었다. 그래서 손상된 저장값을 만났을 때의 동작은 화면에서 재현하지 못했고 자동 테스트로만 확인했다. 삭제 동작은 S0 화면에서는 실행했지만, S1 이후에는 검사 도구에서 동작 시점의 별도 안전 확인이 필요해 화면에서 반복하지 않았다. 대신 이전 단계부터 그대로 유지한 자동 테스트로 확인했다.

    마지막 새로고침 검사에서는 검사 도구가 화면의 특정 요소를 찾는 두 번의 시도에서 시간 초과가 났다. 화면 전체 구조와 항목 목록을 한꺼번에 읽는 방식으로 저장된 제목과 나머지 값이 남아 있음을 다시 확인했다. 다만 이 도구 문제를 제품 오류로 세지도 않았고, 첫 시도에 완전히 성공한 것으로 기록하지도 않았다.

    이 범위 때문에 표의 통과와 ‘0건’은 검사한 동작에 대한 관찰값이다. 실제 사용자 환경 전체, 다른 앱, 다른 프롬프트, 이미 고장 난 코드 위에서의 유지보수까지 보증하지 않는다.

    참고: 코드 크기와 시간도 함께 기록했다

    앱 코드는 빈 줄을 제외하고 214줄에서 361줄로, 테스트 코드는 37줄에서 123줄로 늘었다. 같은 날 같은 ESLint 9.35.0 classic 규칙으로 측정한 함수별 최대 순환 복잡도는 8에서 10으로 올라갔다. 순환 복잡도는 조건에 따라 코드 실행 경로가 얼마나 갈라지는지 세는 값이다. 미리 정한 기준인 10을 넘는 함수는 없었다. 이 ESLint 버전이 지원 종료 경고를 냈기 때문에 당일 비교용으로만 사용했다. 줄 수와 복잡도는 확인할 표면이 커졌다는 보조값이지 품질 점수가 아니다. 국제 표준 ISO/IEC 25010 역시 제품 품질을 하나의 점수가 아니라 여러 특성과 하위 특성으로 나눠 보는 참조 모델이다. (ESLint complexity, ISO/IEC 25010:2023)

    요청부터 첫 파일 전달까지는 단계별 52~122초, 검증은 72~126초였다. 단계마다 요구와 검사 수가 달라 이 시간만으로 AI가 더 좋아지거나 나빠졌다고 해석할 수는 없다. 마지막 검증 시간에는 화면 요소를 찾지 못한 원인이 앱인지 검사 도구인지 구분한 시간도 포함됐다.

    결론: 기능 추가는 재검사가 끝나야 끝난다

    이번 한 앱에서는 기능 세 개가 수정 요청 없이 추가됐고, 실행한 검사에서 기존 기능이 깨지는 모습은 발견하지 못했다. 그러나 매 단계 실행한 검사가 통과한 스냅숏에서 시작한 한 번의 연속 사례다. 이미 깨진 앱에 계속 기능을 얹는 비용은 측정하지 않았다.

    바이브코딩의 유지보수는 “AI가 코드를 써줬다”에서 끝나지 않는다. 이전에 되던 것이 지금도 되는지 확인하는 일까지 포함해야 비로소 기능 추가가 끝난다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • Cursor로 파일 정리하기: 코딩보다 먼저 확인할 5단계

    Cursor로 파일 정리하기: 코딩보다 먼저 확인할 5단계

    다운로드 폴더가 어지럽다고 곧바로 Cursor에 통째로 맡겨도 될까? 이번 실험에서는 가짜 파일 10개를 이미지·PDF·텍스트·기타 폴더로 정리하는 스크립트를 만들었다. 생성된 스크립트는 코드 수정 없이 이번 세션의 규칙에 따라 가짜 파일 10개를 모두 정확히 옮겼다. 이번 세션에서는 결과를 완료로 판단하기 전에 연습 폴더 → 계획 → 미리보기 → 실행 → 검증의 다섯 단계를 차례로 확인했다.

    이 결과는 인간 초보자의 사용성 시험이 아니다. AI 코딩 에이전트인 Codex가 한 Mac에서 합성 파일로 수행한 단일 세션이다. 따라서 “비개발자는 모두 여기서 막힌다”가 아니라, 실제 파일을 맡기기 전에 무엇을 확인해야 하는지 보여주는 사례로 읽어야 한다.

    파일 카드가 안전 확인 단계를 지나 네 개의 폴더로 정리되는 모습을 표현한 일러스트
    범위 설정, 미리보기, 검증을 거쳐 파일을 정리하는 흐름을 표현한 일러스트. Grok Imagine을 사용해 생성한 AI 이미지입니다.
    이 글의 목차

    1. 원본 대신 연습 폴더를 연다

    실험에는 개인 사진이나 업무 문서를 쓰지 않았다. 별도 작업 공간에 내용까지 전부 가짜인 파일 10개를 만들고, Cursor에서 그 격리 작업 공간을 열어 진행했다. 실제 Downloads 전체를 열면 AI가 읽거나 명령을 실행할 수 있는 범위도 함께 넓어진다. Cursor 공식 설명에 따르면 Agent는 파일을 읽고 편집할 뿐 아니라 터미널 명령도 실행할 수 있다.

    처음이라면 원본이 아니라 복사본 5~10개로 연습하는 편이 낫다.

    2. Plan에서 ‘정리’의 뜻부터 정한다

    처음 요청은 “계획만 만들고 파일과 터미널은 건드리지 말라”였다. Plan Mode 문서는 코드를 쓰기 전에 작업 폴더를 살펴보고 질문과 계획을 만드는 흐름을 설명한다.

    Plan Mode 선택만으로 실행 차단을 가정하지 않고, 이번 요청에는 파일 변경과 터미널 실행 금지를 따로 적었다.

    Cursor는 두 가지를 되물었다.

    1. 결과 폴더를 inbox 안에 둘까, 작업 공간 맨 위에 둘까?
    2. 확장자 없는 README와 archive.zip은 텍스트일까, 기타일까?

    “파일을 정리해 줘”만으로는 정답이 없다는 뜻이다. 목적지, 같은 이름 처리, 확장자 없는 파일, 하위 폴더 규칙을 먼저 말로 정해야 한다. 이번에는 네 결과 폴더를 inbox 안에 만들고, .txt만 Text로 보내며 나머지 미지원 파일은 Other에 보존하기로 했다.

    3. 실행 전에 dry-run을 읽는다

    계획을 확인한 뒤 파일 작성과 명령 실행이 가능한 Build 모드로 바꾸되 실제 이동은 금지하고, 먼저 아래 미리보기만 요청했다.

    python3 organize_inbox.py --dry-run
    

    dry-run은 무엇을 어디로 옮길지 보여주되 파일은 바꾸지 않는 예행연습이다. 출력에는 예정 이동 10건과 다른 위치의 파일을 가리키는 바로가기 같은 심볼릭 링크 1건을 건너뛴다는 결과가 나왔다. 같은 이름의 파일은 숫자 접미사로 둘 다 보존하고, README와 .zip은 Other로 보낼 계획이었다. Cursor와 별도로 실행한 검증에서도 대상 파일은 그대로였다.

    다만 명령 옆에 잠시 Delete attempted(삭제 시도됨)라는 표시가 나타났다. 이유는 확인하지 못했다. 실제 삭제는 없었지만, 이런 표시가 보일 때 모델의 설명만 믿고 넘어가서는 안 된다. 이 표시의 의미를 실제 파일 상태로 확인하기 전에는 실제 이동을 요청하지 않는 편이 안전하다. 이번 세션의 삭제 없음 판정은 독립 검증 결과다. 출발지·목적지·파일 수·제외 항목 설명은 별도의 dry-run 범위 확인 기준이다.

    4. 범위를 확인한 뒤 복사본에서 실행한다

    실제 실행은 명령이 오류 없이 끝났다는 신호인 종료 코드 0을 반환했고, 파일 10개를 옮기고 심볼릭 링크 1건을 건너뛰었다. 명령을 실행해도 되는지 Cursor가 자동으로 판별하는 설정인 Auto-review가 켜진 이 세션에서 명령은 승인 버튼 클릭 없이 실행됐다. Run Modes 문서도 Auto-review가 보안 경계는 아니며 자동 판별이 틀릴 수 있다고 경고한다.

    따라서 “위험하면 Cursor가 반드시 물어볼 것”이라고 기대하면 안 된다. 실행 요청을 보내는 행위 자체를 승인으로 보고, 그 전에 dry-run의 범위가 맞는지 확인해야 한다.

    5. 성공 메시지 대신 파일 상태를 확인한다

    종료 코드 0은 명령이 오류 없이 끝났다는 뜻일 뿐, 결과가 맞다는 보장은 아니다. 이번에는 별도 정답표와 검증기로 다음을 확인했다.

    • 가짜 파일 10개가 정해 둔 네 범주 중 하나에만, 빠지거나 중복되지 않고 존재했다.
    • 파일 내용의 지문 값인 해시가 10/10 보존됐다.
    • 같은 이름의 두 파일이 덮어써지지 않았다.
    • inbox 밖에 일부러 둔, 건드리면 안 되는 확인용 파일과 심볼릭 링크가 바뀌지 않았다.
    • 같은 명령을 다시 실행했을 때 추가 이동이 0건이었다.

    심볼릭 링크 대상을 단순히 읽었는지까지는 탐지하지 못했다. 그래도 실제 사용자는 원본을 남기고, 미리보기와 실행 후의 파일 수를 비교하고, 같은 이름이 둘 다 살아 있는지 확인하는 것부터 시작할 수 있다. Agent의 마지막 문장보다 실제 파일 상태를 완료 기준으로 삼는 것이 핵심이다.

    이 사례에서 권하는 확인 순서

    1. 원본이 아닌 복사본 5~10개로 연습 폴더를 만든다.
    2. Plan에서 “계획만, 파일 변경과 터미널 실행 금지”라고 쓴다.
    3. 목적지·중복 이름·확장자 없는 파일·하위 폴더 규칙을 답한다.
    4. “덮어쓰기·삭제 금지, 심볼릭 링크 건너뛰기”를 명시한다.
    5. Build에서 스크립트와 --dry-run까지만 요청한다.
    6. 미리보기의 출발지·목적지·건수·제외 항목을 확인한다.
    7. 범위가 맞으면 복사본에서 실제 실행을 한 번 요청한다.
    8. 실행 후 파일 수와 같은 이름 파일이 모두 남았는지 확인한 뒤, dry-run을 다시 실행해 추가 예정 이동이 0건인지 본다.

    실험에서는 두 번째 실제 실행으로 추가 이동 0건을 확인했다. 위 권고는 독자가 불필요한 실제 재실행 대신 dry-run으로 다시 확인하도록 더 좁힌 절차다.

    참고: 이번 실험의 조건과 기술적 한계

    • 기준일: 합성 실험 2026년 9월 2일, 공식 문서 재확인 2026년 9월 6일
    • 환경: Cursor 3.18.25, Cursor Grok 4.6 Medium, Apple Silicon Mac
    • 로그인: 로그인 전 시도는 Log In과 Sign Up 화면에서 멈췄고, 계정 소유자가 로그인한 뒤 별도 세션에서 재개. 절차의 난이도와 시간은 미측정
    • 결과: 자연어 메시지 5회, 추가 질문 2개, 코드 수정 요청 0회, 기능 오류 0회
    • Cursor 표시 Agent 작업 시간: 8분 31초. 설치·사용자 로그인·독립 검증 시간은 제외
    • 판정: 이 합성 파일 10개에 한정해 첫 실행 성공, 분류 10/10, 두 번째 실행 추가 이동 0건
    • .cursorignore는 AI 문맥에서 파일을 제외하지만 Agent의 터미널·외부 도구 접근까지 막는 경계는 아니다.
    • Privacy Mode 설명에서 학습에 쓰지 않는다는 말은 파일 내용이 Cursor 서버를 거치지 않는다는 뜻이 아니다. 이번 세션에서는 Privacy Mode 활성 여부를 측정하지 않았다.
    • Checkpoint는 Agent 변경용 로컬 복원 지점이지 완전한 백업이나 Git 대체물이 아니다. 이번 세션에서는 복원을 시험하지 않았다.

    이 세션에서 코드 수정 요청은 0회였다. 그 뒤에도 확인할 대상은 남았다. 작게 격리하고, 계획을 읽고, 미리 본 뒤, 실제 파일 상태를 확인하는 순서다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.
  • 실행 전 멈춘 v0 30분 실험: 완성을 판단하는 체크리스트

    실행 전 멈춘 v0 30분 실험: 완성을 판단하는 체크리스트

    이 글은 AI 웹사이트 제작 도구 v0로 랜딩 페이지를 생성해 본 후기가 아니다. 2026년 9월 2일, Codex 에이전트가 정해 둔 30분 실험을 시작하려 했지만 에이전트가 쓸 수 있는 두 브라우저 모두 v0에 로그인되어 있지 않았다. 계정이나 로그인 상태를 바꾸지 않는다는 규칙에 따라 에이전트는 프롬프트를 보내기 전에 멈췄고, 타이머도 시작하지 않았다.

    따라서 이번 기록으로는 v0로 30분 안에 랜딩 페이지를 완성해 공개하고 확인할 수 있는지 판단할 수 없다. 대신 무엇을 확인해야 ‘30분 완성’이라고 부를 수 있는지, 실행 전에 고정한 체크리스트를 정리한다.

    프롬프트에서 랜딩 페이지, 반응형 확인, 배포 검증으로 이어질 예정이었던 30분 실험을 표현한 추상 일러스트
    30분 실험의 계획을 표현한 일러스트이며 실제 v0 생성 화면이 아닙니다. Grok Imagine을 사용해 생성한 AI 이미지입니다.
    이 글의 목차

    실제로 확인한 것은 로그인 전 화면뿐이다

    정해진 절차를 수행하는 Codex 에이전트는 두 곳에서 v0 홈을 열었다. 하나는 에이전트가 사용하는 내부 브라우저, 다른 하나는 에이전트가 조작할 수 있게 연결된 일반 Chrome이었다. 내부 브라우저의 v0.dev 홈에는 Log In, Sign Up이 보였고, Chrome의 v0.dev 탭에서도 메뉴를 열자 같은 두 항목이 나타났다. 두 환경 모두 기존 세션이 없었다. 홈 화면에 v0 Max라는 이름도 보였지만 로그인 전 화면에 표시된 문구였을 뿐이다. 무료 계정에서 실제로 어떤 모델이 쓰이는지에 대한 증거로는 삼지 않았다.

    프로젝트 생성, 프롬프트 전송, 결과 미리보기, 수정, 배포는 하나도 실행하지 않았다. 사용량 화면도 관찰하지 않아 시작·종료 크레딧을 기록하지 못했다. 그래서 생성 품질, 수정 횟수, 반응형 화면, 접근성, 폼 동작, 비용, 프로덕션 주소는 모두 미검증이다. 로그인 화면에서 멈춘 사실은 제품 실패도, 30분 성공도 증명하지 않는다.

    ‘30분’에는 생성 뒤의 확인까지 들어가야 한다

    예쁜 첫 화면이 나타난 순간을 완료로 잡으면 걸린 시간은 짧아 보일 수 있다. 이 실험은 첫 프롬프트 전송부터 생성 대기, 요구사항 확인, 자연어 수정, 반응형·키보드 검사, 프로덕션 배포, 로그아웃 상태 확인까지를 하나의 연속 타이머에 넣도록 설계했다.

    2026년 9월 10일 확인한 v0의 공식 빠른 시작은 프로덕션 게시를 생성·편집 뒤의 별도 단계로 안내하며, 이 처음부터 게시까지의 종단 경로에 걸리는 총시간을 약속하지 않는다. 별도로 정한 실험 절차는 실행이 시작될 경우 네 시점—첫 화면 표시, 마지막 수정(수정한 경우), 게시 클릭, 로그아웃 상태 확인—을 기록하도록 한다.

    비개발자가 확인할 완성 체크리스트

    아래 항목을 모두 확인하기 전에는 ‘30분 안에 랜딩 페이지를 완성해 공개했다’고 판정하지 않는다.

    • 요구사항: 필요한 섹션과 행동 버튼이 있고, 예시 후기와 가상 서비스를 실제 고객·실서비스로 오해하지 않게 표시했는가?
    • 기능: 페이지 안의 특정 위치로 이동하는 링크, 버튼, 필수 입력 검사, 폼 전송 뒤의 완료 표시가 실제로 동작하는가?
    • 반응형: 스마트폰·태블릿·데스크톱 크기인 375×812, 768×1024, 1440×900 CSS 픽셀 모두에서 가로 스크롤·겹침·핵심 내용 잘림 없이 표시되는가?
    • 접근성 기본선: 마우스 없이 링크·버튼·폼으로 이동할 수 있고, 지금 어디에 있는지 테두리 등으로 보이는가? 입력란에 이름표가 있고 제목 순서가 자연스러우며, 주요 글자·행동 버튼과 배경의 색 차이가 눈에 띄게 부족한 곳이 없는가?
    • 배포: 미리보기나 공유 링크가 아니라 프로덕션 게시로 만든 고정 주소를 로그아웃 상태에서도 열 수 있는가?
    • 무료 범위: 시작·종료 크레딧과 메시지 수를 기록했고 결제나 유료 전환 없이 끝났는가?
    • 데이터 안전: 실제 개인정보, 외부 API, 데이터베이스, 실제 이메일 전송을 모두 배제했는가?
    • 고친 뒤 확인: 문구나 필수 입력 검사의 오류를 고친 뒤에도 나머지가 그대로 동작하는가? 수정할 항목이 없다면 해당 없음으로 기록했는가?

    앞의 여섯 항목은 결과와 사용 조건을 확인하는 기준이고, 마지막 두 항목은 안전과 ‘고친 뒤 다른 곳이 깨지지 않았는지’를 보는 기준이다. 여덟 항목은 모두 최종 판정 전에 확인하고, 실행할 상황이 없었던 항목은 해당 없음과 그 이유를 남긴다. 이 체크는 완전한 접근성 감사나 전문 디자인 평가가 아니다. 기본적인 실패를 놓치지 않기 위한 최소선이다. 한 번 통과하더라도 모든 비개발자가 같은 시간 안에 성공한다고 일반화할 수 없다.

    무료 기능과 실제 운영 조건은 구분해야 한다

    2026년 9월 10일 v0 공식 가격 페이지를 확인했을 때 Free 플랜은 월 0달러, 월 5달러 크레딧, 하루 7개 메시지로 안내됐다. 같은 날 확인한 가격 문서에 따르면 토큰 사용량은 입력·출력 길이와 대화 기록·소스 파일을 포함한 관련 문맥에 따라 달라진다. 하루 7개 메시지라는 숫자만으로 한 페이지를 끝낼 수 있다고 계산할 수는 없다.

    같은 날 확인한 배포 문서는 프로덕션 게시가 v0 작업을 연결된 Vercel 프로젝트의 고정된 프로덕션 주소에 반영한다고 설명한다. 같은 날 확인한 Vercel Hobby 플랜은 개인·비상업 용도로 제한된다. 무료 실험에 성공하더라도 Hobby 플랜에서 상업용 사이트 운영이 허용된다는 뜻은 아니다. 가격·기능·약관은 바뀔 수 있으므로 실제 실행일과 발행 전에 다시 확인해야 한다.

    지금 내릴 수 있는 결론은 ‘미검증’이다

    공식 문서가 기능을 나열한다고 해서 30분 안에 품질 확인과 공개 검증까지 끝난다는 뜻은 아니다.

    이번 시도는 타이머를 시작하기도 전에 멈췄다. 따라서 답은 성공도 실패도 아닌 미검증이다. 직접 시험한다면 먼저 완료 기준을 적고, 첫 화면 표시가 아니라 로그아웃 상태의 프로덕션 주소 확인까지 시간을 재자. 확인하지 못한 칸을 결과처럼 채우지 않는 것이 ‘30분 완성’ 주장을 검증하는 출발점이다.

    브라우저 사전 확인은 Codex 에이전트가 정해진 절차와 안전 경계에 따라 수행했습니다.

    이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.

    공식 자료