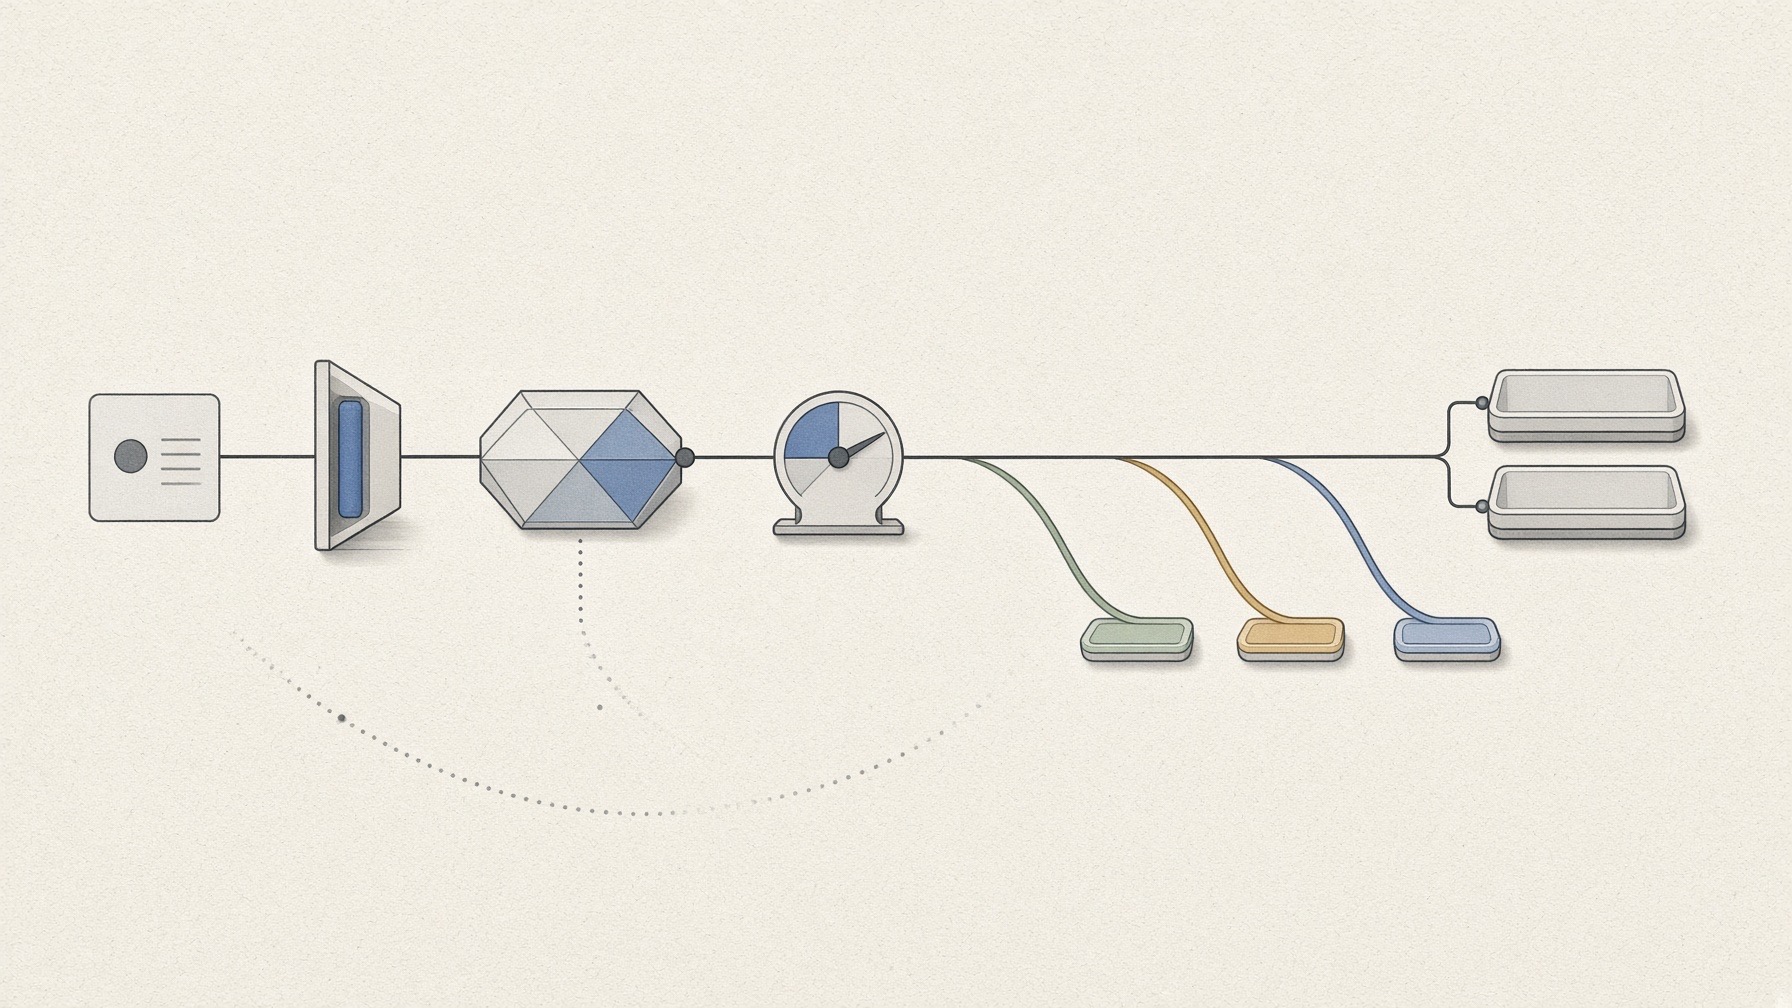
예약 실행을 믿는다는 건 결과 문장이 그럴듯하다는 뜻이 아니다. 어떤 입력을 읽었고, 허용된 일만 했으며, 검사를 통과했고, 필요할 때 멈췄다는 기록을 다시 확인할 수 있는가가 이 글에서 말하는 신뢰다.
이 구분이 필요한 이유는 간단하다. 일정이 등록됐고, 작업이 끝났고, 보고서 파일이 쓰였고, 그 내용을 믿어도 된다는 말은 서로 다른 상태다. 2026년 9월 12일에 확인한 OpenAI Scheduled tasks 안내는 저장된 프롬프트와 실행 시점을 구분하고, 로컬 파일을 쓰는 데스크톱 작업의 조건을 설명한다. 또한 좁은 권한과 초기 실행 검토를 권한다. 다만 확인한 페이지에는 결과 정확성, 일반적인 재시도·겹침 동작, 실행당 비용 상한, 보편적인 중간 취소 계약이 제시돼 있지 않았다. 그래서 실제 일정을 켜는 대신, 합성 데이터와 논리시계—실제 시간을 기다리지 않고 고정된 사건 목록을 차례로 진행하는 방식—로 운영 장치를 먼저 연습했다.
이 글의 목차
그럴듯한 어제 보고서
실제 AI 호출은 없었다. 핵심 장면은 정해진 규칙대로 문장을 만드는 후보 생성기로 일부러 만든 ‘낡았지만 자연스러운’ 보고서였다. 검증기가 기대한 입력은 SYN-20260902였지만 후보가 실제로 읽은 것은 SYN-20260901이었다. 낡은 파일을 바탕으로 만든 보고서는 내부적으로 그럴듯해서 문장만 보면 이상하지 않았다.
하지만 작성은 승인과 달랐다. 독립적으로 고정한 기대 snapshot ID와 입력 해시를 후보가 기록한 실제 값과 비교하자 검증 기록에 binding_mismatch가 남았다. 후보는 accepted 폴더로 가지 못하고 quarantine으로 옮겨졌으며, 보고서를 받아 볼 사람이 보게 될 결과는 rejected_binding_mismatch 라벨의 거절 기록이었다. 이 한 건은 AI의 신뢰도를 보여주는 비율도, AI가 낡은 입력을 알아봤다는 증거도 아니다. 심어 둔 검증 장치가 낡은 입력을 거절했는지 확인한 통제 사례다.
실제 일정 없이 무엇을 시험했나
실험은 외부 모델을 부르지 않는 고정형 후보 생성기(canned deterministic candidate)를 사용했다. 실제 AI의 글쓰기 능력이 아니라 반복 작업을 둘러싼 로컬 실행 장치(wrapper)와 검증기(verifier)를 살펴보기 위해서다. 트리거 역할의 실행기(driver)는 미래 시간을 기다리지 않고 유한한 사건 목록에서 논리시계만 진행했다. 후보 생성기는 실행기가 고른 합성 JSON과 실행 ID를 받았다. 검증기는 따로 고정한 입력 식별값과 정답표(content oracle)를 이용해 입력 identity와 count/change를 대조했다. 검사를 통과한 경우에만 저장기(writer)가 staging 결과를 승인된 최종 산출물(authoritative artifact)로 승격했다.
종이에 허용한 범위, 실제로 막은 통로, 남긴 기록도 서로 다르다. 작업 명세는 읽기·쓰기 범위를 정했고, 로컬 wrapper는 후보 생성기에 network·browser·subprocess·scheduler·provider 통로를 제공하지 않았다. ledger는 wrapper가 관찰한 결정을 남겼다. 이것은 OS 격리나 vendor sandbox를 증명하지 않는다. 이 제한은 후보 생성기에 관한 것이며, wrapper 자체는 파일을 썼다. 실험은 read-only가 아니라 read-centered였다. 실행 루트에는 baseline, staging, verifier, accepted, rejected, quarantine, ledger, inventory, summary 산출물이 기록됐다.
12개 case의 결과
12개 case는 하나의 점수로 평균 내지 않고, 고정된 기대 결과와 각각 비교했다.
- 승인: fresh baseline, 같은 날짜의 변경된 현재 snapshot, 새 날짜의 no-change 보고서는 검증 뒤 accepted가 됐다.
- 시작 전 차단: 누락·schema 오류는 후보 실행 전에 막혔고, 같은 작업이 두 번 도착한 경우에는 두 번째 산출물이 생기지 않았다.
- 충돌과 재시도: 다른 binding의 겹친 요청은 conflict로 기록됐고 원래 binding이 accepted로 남았다. staging 뒤 심어 둔 일시 오류는 첫 결과를 격리한 뒤 모의 재시도 한 번으로 accepted가 됐다. 계속되는 오류는 retry ceiling에서, 재시도하지 않기로 정한 오류는
stopped_nonretryable이유로 멈췄다. - 별도 중단: C10의 심어 둔 case-local 예산 거절은 후보 실행 전 0회에서
stopped_local_budget으로 끝났다. future-run stop, active-local interruption, 모의 read-policy 회수도 서로 다른 이유로 기록됐다.
12개 논리 case가 모두 고정된 기대 disposition과 일치했다. 후보 호출은 계획한 11회였고 전체 series의 hard ceiling 20회를 넘지 않았다. C10의 시작 전 거절은 이 20회를 소진했다는 뜻이 아니다. 전체 재생 실행은 25.229ms였으며, 앞 기록과 이어져 변경을 드러내는 hash chain을 가진 ledger 47행이 검증됐다. 이 숫자는 빠른 실제 업무를 뜻하지 않는다. 작은 로컬 fixture와 고정형 후보 생성기의 실행 시간일 뿐이다.
중단은 하나의 버튼이 아니었다
‘앞으로의 실행 막기’는 due event 전에 저장된 marker와 이후 작업 부재로 확인했다. ‘진행 중인 로컬 단계 끊기’는 중단 요청과 확인, partial quarantine, 승격 부재로 확인했다. ‘모의 로컬 읽기 권한 회수’는 새 policy hash를 source 접근 전에 평가했고 cached fallback을 만들지 않았다. 어느 것도 vendor queue, 원격 실행 취소, 계정 권한 회수를 시험한 것은 아니다.
비용 기록은 왜 다섯 줄인가
- provider 호출: wrapper 경계에서 0회
- 추가 청구 관찰: billing 화면에 접근하지 않아
not_checked - usage 값: unavailable
- local invocation ceiling: 20회이며 이 driver가 통제한 한계
- provider가 강제한 cap: not verified
따라서 “비용 0”이라고 말할 수 없다. 20회 ceiling도 provider 예산 상한이 아니다. 내가 통제한 한계만 강제할 수 있으며, 기록에도 그 경계를 밝혀야 한다.
예약 전에 답할 일곱 질문
반복 자동화를 켜기 전에 다음을 한 줄씩 답해 볼 수 있다.
- 정확히 어떤 입력을 읽는가?
- 허용된 행동과 금지된 행동은 무엇인가?
- 후보와 승인된 결과는 어디에 따로 저장되는가?
- 성공을 무엇으로 검증하는가?
- 내가 실제로 강제할 수 있는 비용·호출 상한은 무엇인가?
- 어떤 오류만 몇 번 재시도하는가?
- 미래 실행, 진행 중 단계, 읽기 권한을 각각 어떻게 멈추는가?
빈칸이 있다면 그것은 모델의 지능 문제가 아니라 운영 설계의 빈칸이다. 이번 실험에서 말할 수 있는 결론도 조건부다. 이 local wrapper와 verifier는 고정된 synthetic case에서 명세대로 움직였다. 시험하지 않은 것(NOT TESTED): AI 출력 동작, 실제 예약 실행, vendor의 trigger·retry·overlap·cancel·delivery, OS/vendor isolation, distributed exactly-once delivery, zero cost, provider spending cap, 실제 활성화 준비도.
이 글은 AI를 활용해 자료 조사와 초안 작성을 보조하고, 작성자가 직접 검증·편집했습니다.


답글 남기기